不少小伙伴面试的时候,都碰到过这道题。
「在浏览器地址栏输入一个 URL,按下回车,到页面展示出来,中间发生了什么?」
这题被写了几百遍。每次都是「第一步 DNS 解析,第二步 TCP 握手…」,读完跟背课文一样,过几天又忘了。
今天换个讲法。
让我,一个 HTTP 数据包,亲口给你讲讲我这一趟到底经历了什么。
你可以叫我孤单小弟。一会儿你就知道我为什么叫这个名字了。
先看一眼我的旅程全貌,
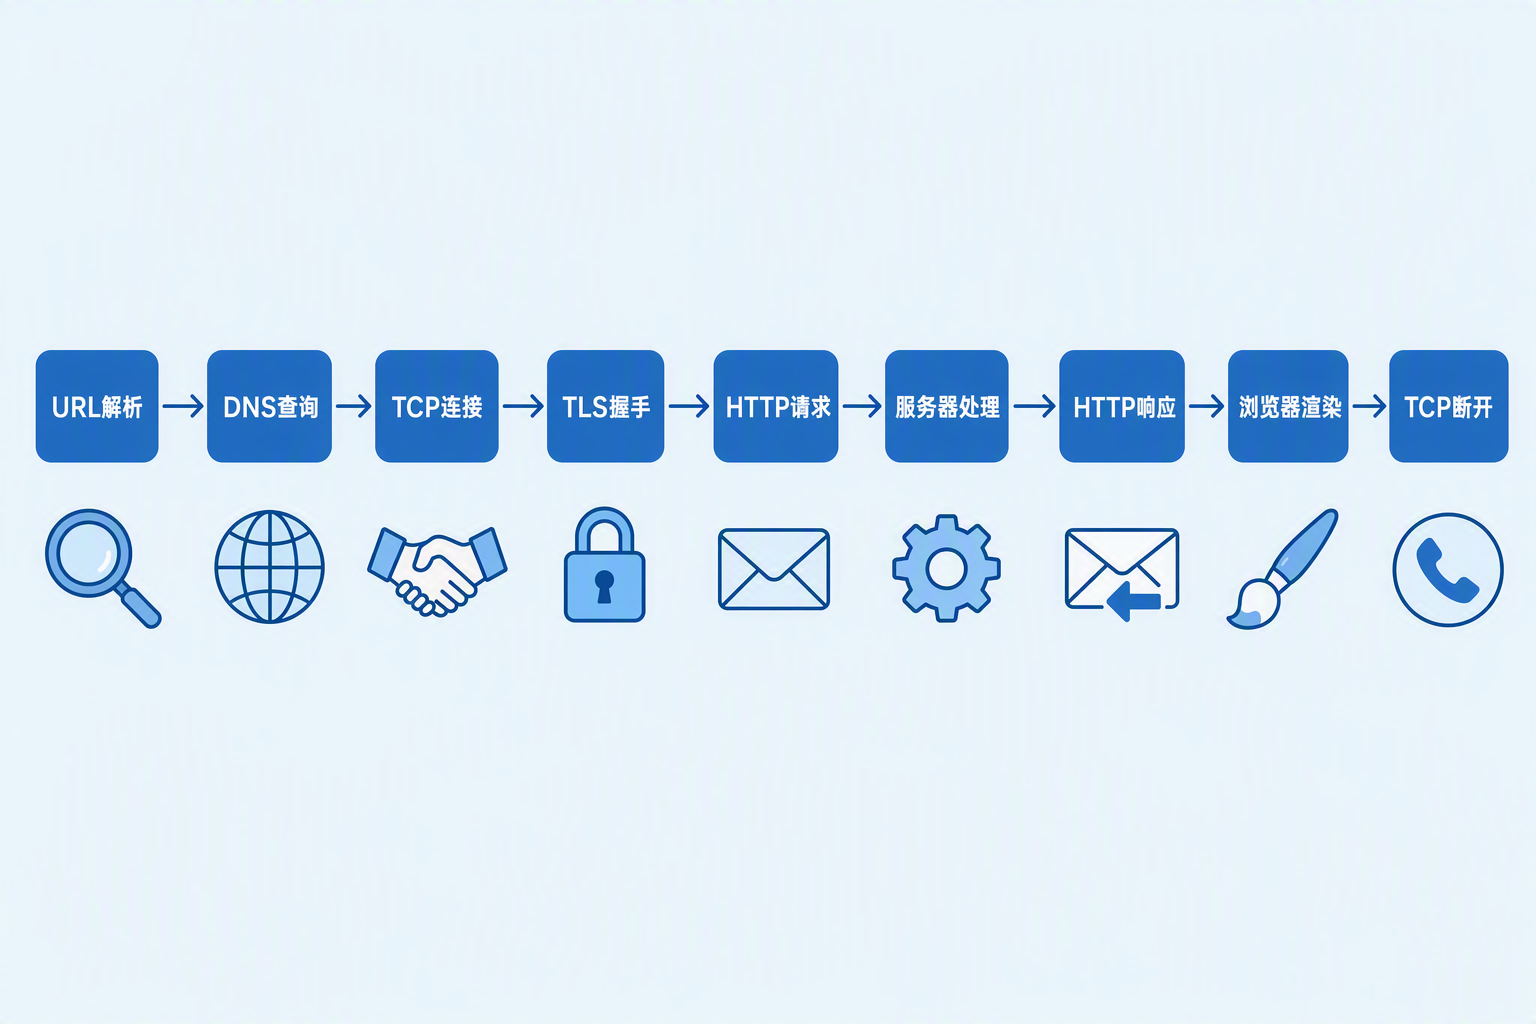
九个阶段,每个阶段都有不同的人帮我。也有不少坎差点过不去。
咱们从头聊。
大管家拆信封,我还躺在工作台上
用户按下回车的那一刻,发生了什么?
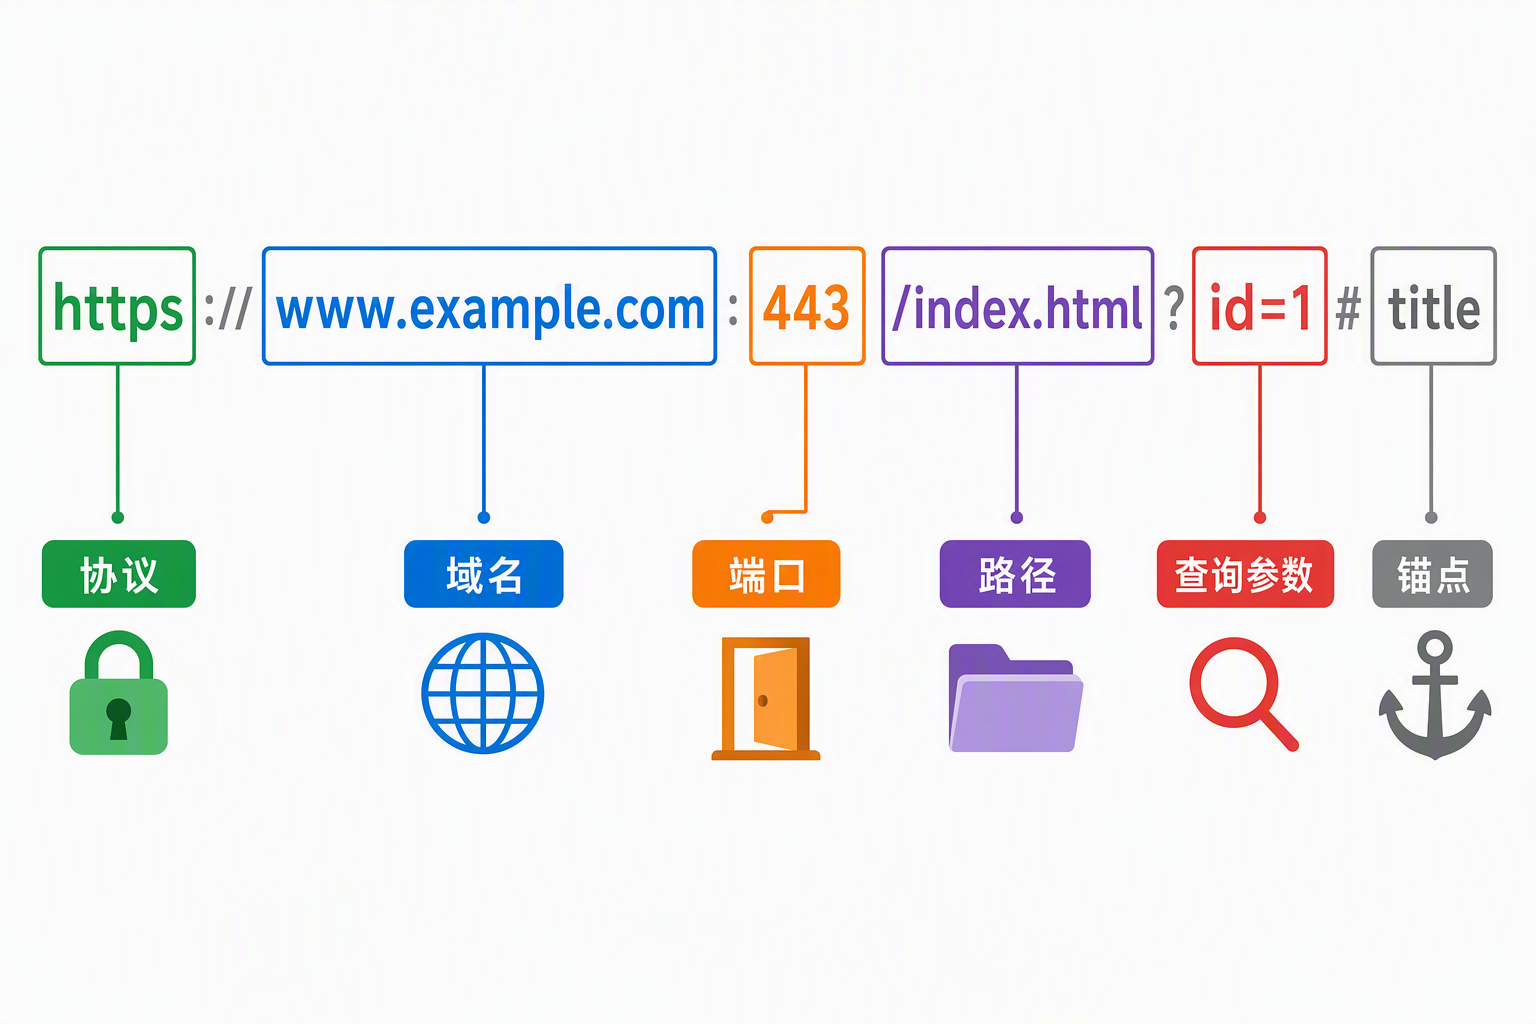
你在地址栏敲下 https://www.example.com/index.html?id=1#title,然后按了回车。
这个动作对你来说只是手指一按。但对浏览器大管家来说,活才刚开始。
大管家是个谨慎的人。它拿到你输入的这串字符,第一反应是先搞清楚你想干嘛,造我的事得往后排。你输入 www.google.com,它认为这是网址。你输入「今天天气怎么样」,它直接丢给搜索引擎。判断逻辑不复杂,有协议前缀 https:// 或者长得像域名的当网址,剩下的当搜索词。
确认是网址之后,大管家开始拆解这个 URL。就像拆一封信,信封上写着收件人、地址、楼层、房间号,每一段都有用。
| 部分 | 值 | 作用 |
|---|---|---|
| 协议 | https | 用什么方式通信 |
| 域名 | www.example.com | 找谁 |
| 端口 | 443 | 走哪扇门(HTTPS 默认 443,HTTP 默认 80) |
| 路径 | /index.html | 要哪个资源 |
| 查询参数 | id=1 | 附加条件 |
| 锚点 | #title | 页面内定位(不会发给服务器) |
拆完 URL 之后大管家还忙什么?
大管家还要干两件事。
第一件,查 HSTS 列表。HSTS 是一份「必须用 HTTPS 的网站清单」。如果这个域名在列表里,即使你输入的是 http://,大管家也会自动帮你改成 https://。这一步是安全加固,防止有人在中间截流明文请求。
第二件,翻缓存。如果你之前访问过这个地址,大管家会看一眼自己的储物柜。缓存没过期的话(通过响应头里的 Cache-Control 或 Expires 判断),大管家直接从本地拿出上次存的内容,页面秒开。这种情况下,后面的 DNS、TCP、HTTP 全都不用跑,我也不用出门了。
但大多数时候没这么好的运气。缓存没命中,大管家就得给我找一条路出去。问题来了,www.example.com 是给人看的名字,网络上真正认的是 IP 地址。
大管家不知道 www.example.com 住在哪。
得有人帮我问路。
帮我问路,DNS 和三位大哥
域名是怎么变成 IP 地址的?
DNS 解析这个过程,和你在陌生城市找人问路非常像。只指路,不带路。
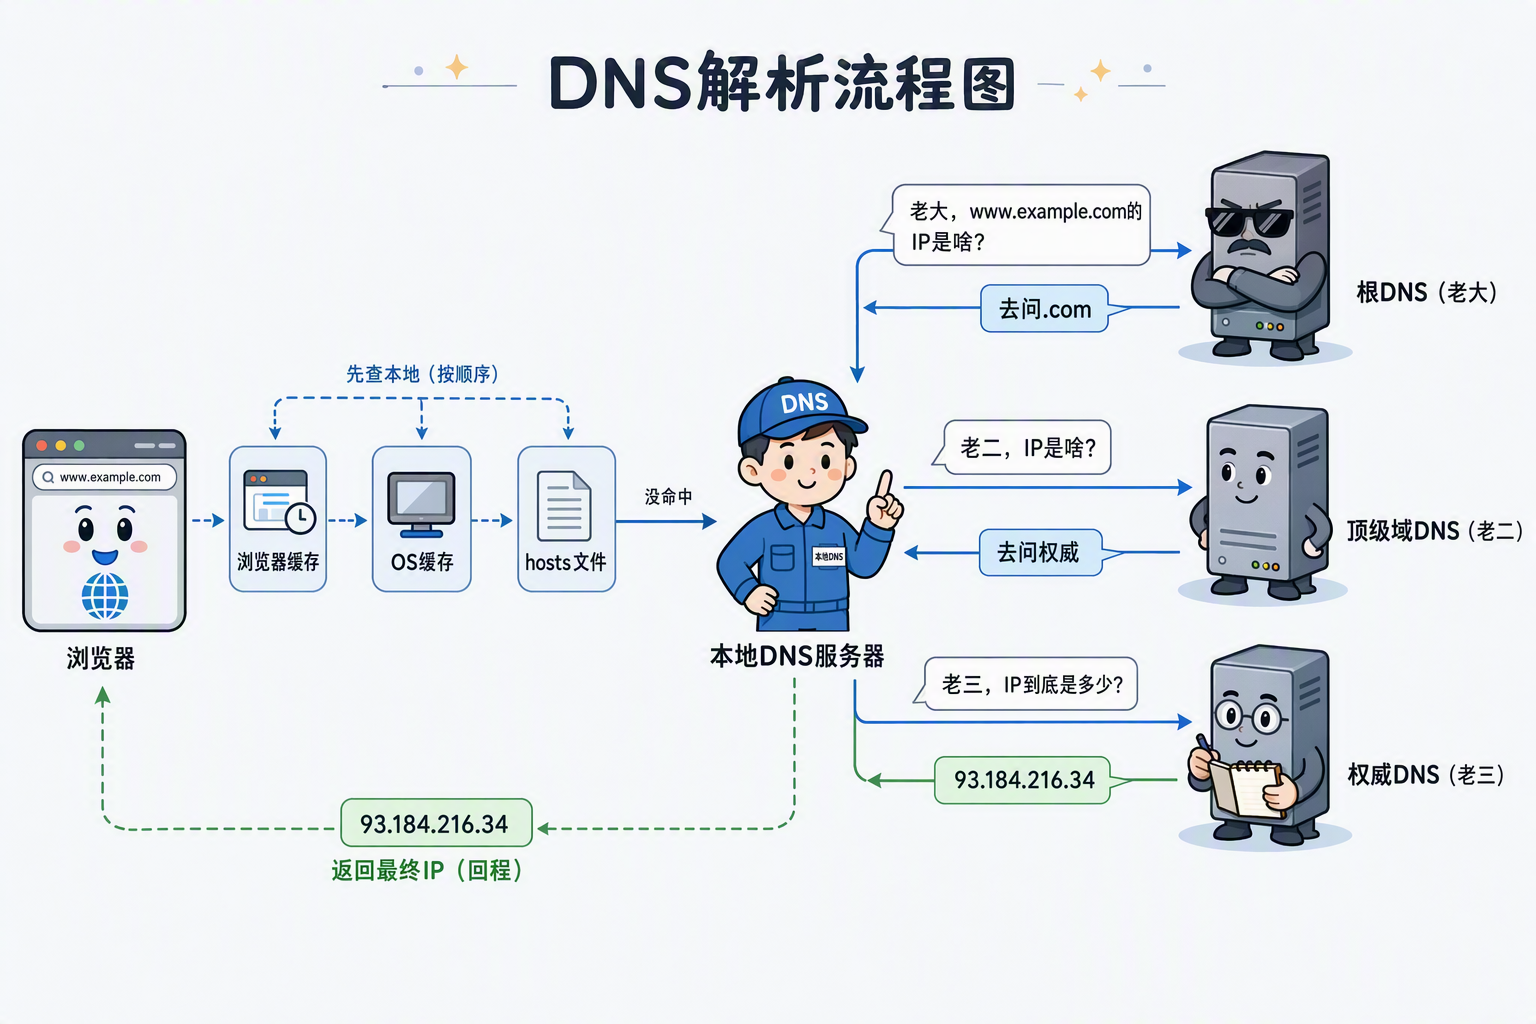
大管家带着域名 www.example.com 出门找 IP 地址。它不会一上来就满大街跑,而是先在家门口问一圈。
第一站,浏览器自己的 DNS 缓存。
大管家会在自己的内存里维护一张域名到 IP 的映射表。你之前访问过 www.example.com,这里可能还存着上次查到的结果。找到了直接用,省一趟远路。每条记录都有有效期(TTL),过了期就作废,得重新查。
第二站,操作系统的 DNS 缓存。
大管家没查到?往下一层问操作系统。操作系统也维护一份自己的 DNS 缓存,独立于浏览器。
第三站,hosts 文件。
操作系统还会查本地的 hosts 文件(Linux/Mac 在 /etc/hosts,Windows 在 C:\Windows\System32\drivers\etc\hosts)。这个文件里可以手动写死域名和 IP 的对应关系。开发的时候拿来做本地测试挺方便。
第四站,本地 DNS 服务器。
上面三站都没查到,操作系统就得出门了。它把查询请求发给本地 DNS 服务器,一般是运营商提供的,也可能是你手动配的 8.8.8.8(Google)或者 114.114.114.114。
本地 DNS 服务器收到请求后,先查自己的缓存。有的话直接返回。没有的话,它就开始帮你跑腿了。
本地 DNS 服务器是怎么跑腿的?
这是整个 DNS 解析最精彩的部分。本地 DNS 服务器要去问三个大哥。
- 本地 DNS 先去找根域名服务器,也就是老大。「大哥,能告诉我 www.example.com 的 IP 是啥吗?」
- 老大说,「www.example.com 这个域名归 .com 管,我把 .com 顶级域名服务器的地址给你,你去问老二。」
- 本地 DNS 转向 .com 顶级域名服务器。「二哥,你能告诉我 www.example.com 的 IP 地址吗?」
- 老二说,「我给你 example.com 的权威 DNS 服务器地址,你去问老三。」
- 本地 DNS 再转向权威 DNS 服务器。「三哥,www.example.com 对应的 IP 到底是多少?」
- 老三查了一下自己的记录本,「是 93.184.216.34。」
- 本地 DNS 拿到 IP 后,先存一份到自己的缓存里(下次别人问就不用再跑了),然后把结果原路返回给操作系统,操作系统再返回给浏览器。
域名为什么要分层级?
你可能好奇,老大老二老三的分工依据是什么。看一眼域名的层级结构就明白了。
域名其实从右往左读,
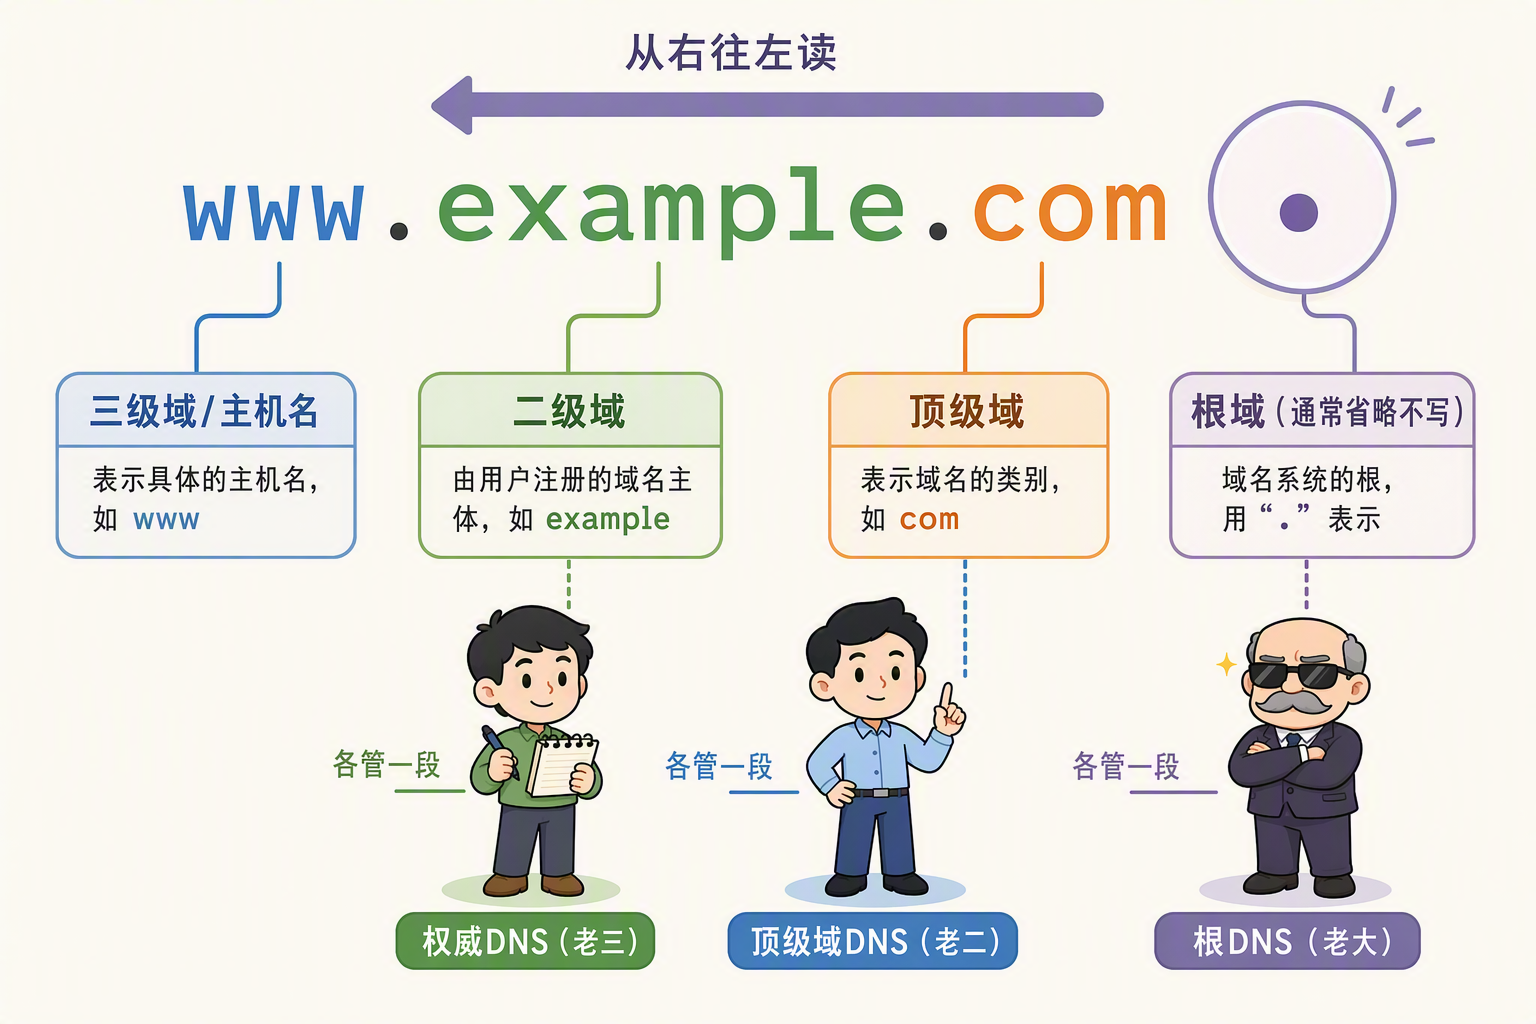
根 DNS 管的是最顶层那个点,顶级域 DNS 管 .com / .cn / .org 这些,权威 DNS 管具体的 example.com。层级分明,各管一段。全球只有 13 组根 DNS 服务器(用任播技术部署了上千个实例),它们是整个互联网域名解析的起点。
DNS 用的是 TCP 还是 UDP?
绝大多数 DNS 查询用的是 UDP,端口 53。原因很简单,DNS 查询通常就一个请求一个响应,数据量小,UDP 快,不用握手。但如果响应数据超过 512 字节(比如区域传输,或者挂了很多 TXT 记录),就会切换到 TCP。现在越来越多的 DNS 部署开始支持 DoH(DNS over HTTPS)和 DoT(DNS over TLS),把 DNS 查询也加密起来,防止运营商劫持或者中间人偷看你在访问什么网站。
现在大管家终于拿到了 IP 地址 93.184.216.34。
我开始兴奋了。我知道自己要去哪了。但有了地址还不够,路还没通。就像你知道了对方的电话号码,打过去之前得先确认有没有人接。
这一步叫 TCP 连接。
帮我修路,TCP 的三次握手
TCP 三次握手到底在干什么?
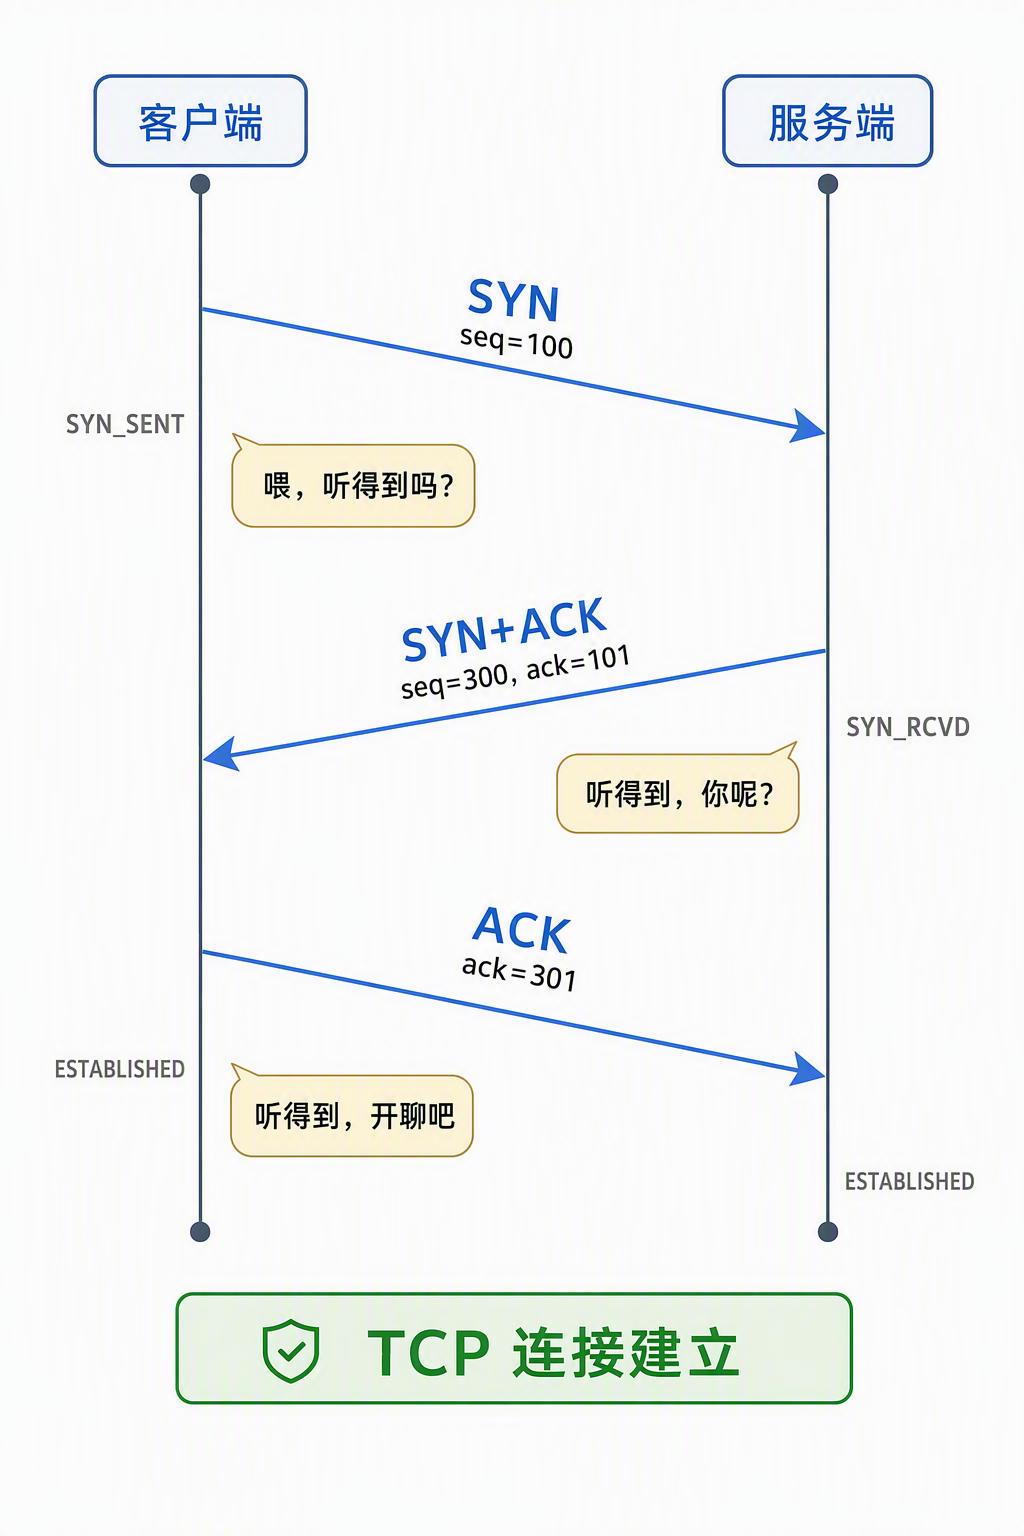
我们打个比方。假设你跟朋友在嘈杂的酒吧打电话,你想确认双方都听得到对方说话。
- 你说,「喂,听得到吗?」
- 对方说,「听得到,你听得到我吗?」
- 你说,「听得到,那咱们聊吧。」
三句话,就建立了一个「双方都确认能通信」的信道。
翻译成网络协议,
- 客户端发送 SYN 包给服务端,「我想跟你建立连接。」客户端进入 SYN_SENT 状态。这个 SYN 包里带了一个随机生成的初始序列号(ISN),比如
seq=100。序列号是 TCP 用来追踪每一个字节的编号系统,后面传数据全靠它。 - 服务端收到后,回复 SYN + ACK 包,「好的我同意,但你确认收到我的回复了吗?」服务端进入 SYN_RCVD 状态。这个包里带了服务端自己的初始序列号
seq=300,同时确认号ack=101,表示「你的 100 我收到了,下次从 101 开始」。 - 客户端收到后,发一个 ACK 包,确认号
ack=301,告诉服务端「你的 300 我也收到了」。双方进入 ESTABLISHED 状态。
至此,TCP 连接建立。我画成一个图,
为什么不是两次就够了?
你看,如果只有两次,
- 客户端说,「喂听得到吗?」
- 服务端说,「听得到。」
这时服务端不知道客户端到底收没收到自己的回复。万一客户端那边信号中断了呢?服务端就傻傻地分配好内存、建好数据结构在那等着,白白占用资源。
还有一个经典的麻烦。假设客户端之前发过一个 SYN 包,但那个包在网络里堵了很久,迟迟没到。客户端以为丢了,又发了一个新的。新的先到了,连接也建好了,数据也传完了,连接也断了。这时候旧的那个 SYN 包终于到了服务端,服务端以为又有人要连接,建了一个连接在那等。没人来,白等。三次握手能避免这种情况,因为客户端收到服务端的 SYN+ACK 后,如果发现这是一个过期的响应,可以发 RST 包拒绝掉,不会让服务端白等。
三次握手的时候能带数据吗?
第三次握手(ACK)的时候可以带数据。因为到第三次的时候,客户端已经知道「双方都能通信」了,带点数据过去没问题。但前两次不行,连接还没建立,带数据不安全。
有一个优化技术叫 TCP Fast Open(TFO)。第一次连接时服务端给客户端一个 Cookie,以后客户端再连同一个服务端时,SYN 包里就能直接带数据 + Cookie,服务端验证 Cookie 后直接处理数据,省掉一个 RTT。Google 在 2011 年提出这个方案,Linux 3.7+ 开始支持。
TCP 连接建好了,路通了。我开始在工作台上成形了,但还不能上路。因为你访问的是 HTTPS 网站,我身上的数据还是明文,谁都能偷看。
得先给我穿上盔甲。
穿上盔甲,TLS 握手
HTTPS 的那个 S 到底加了什么?
HTTP 是明文传输。我身上写了什么,路上的路由器、WiFi 热点、运营商设备都能看到。就像你写了一封信,信封没封口,邮递员想看就看。
HTTPS 在 HTTP 和 TCP 之间加了一层 TLS(Transport Layer Security)。作用就是给我加密。只有发信人和收信人能看懂我身上的内容,中间经过的任何人看到的都是乱码。
比如你跟朋友寄信,在正式通信之前,你们先交换一本暗号本。以后的每一封信都用暗号写,即使邮递员偷看也看不懂。TLS 握手干的就是这件事,协商加密方式、交换密钥。
TLS 握手具体怎么做?
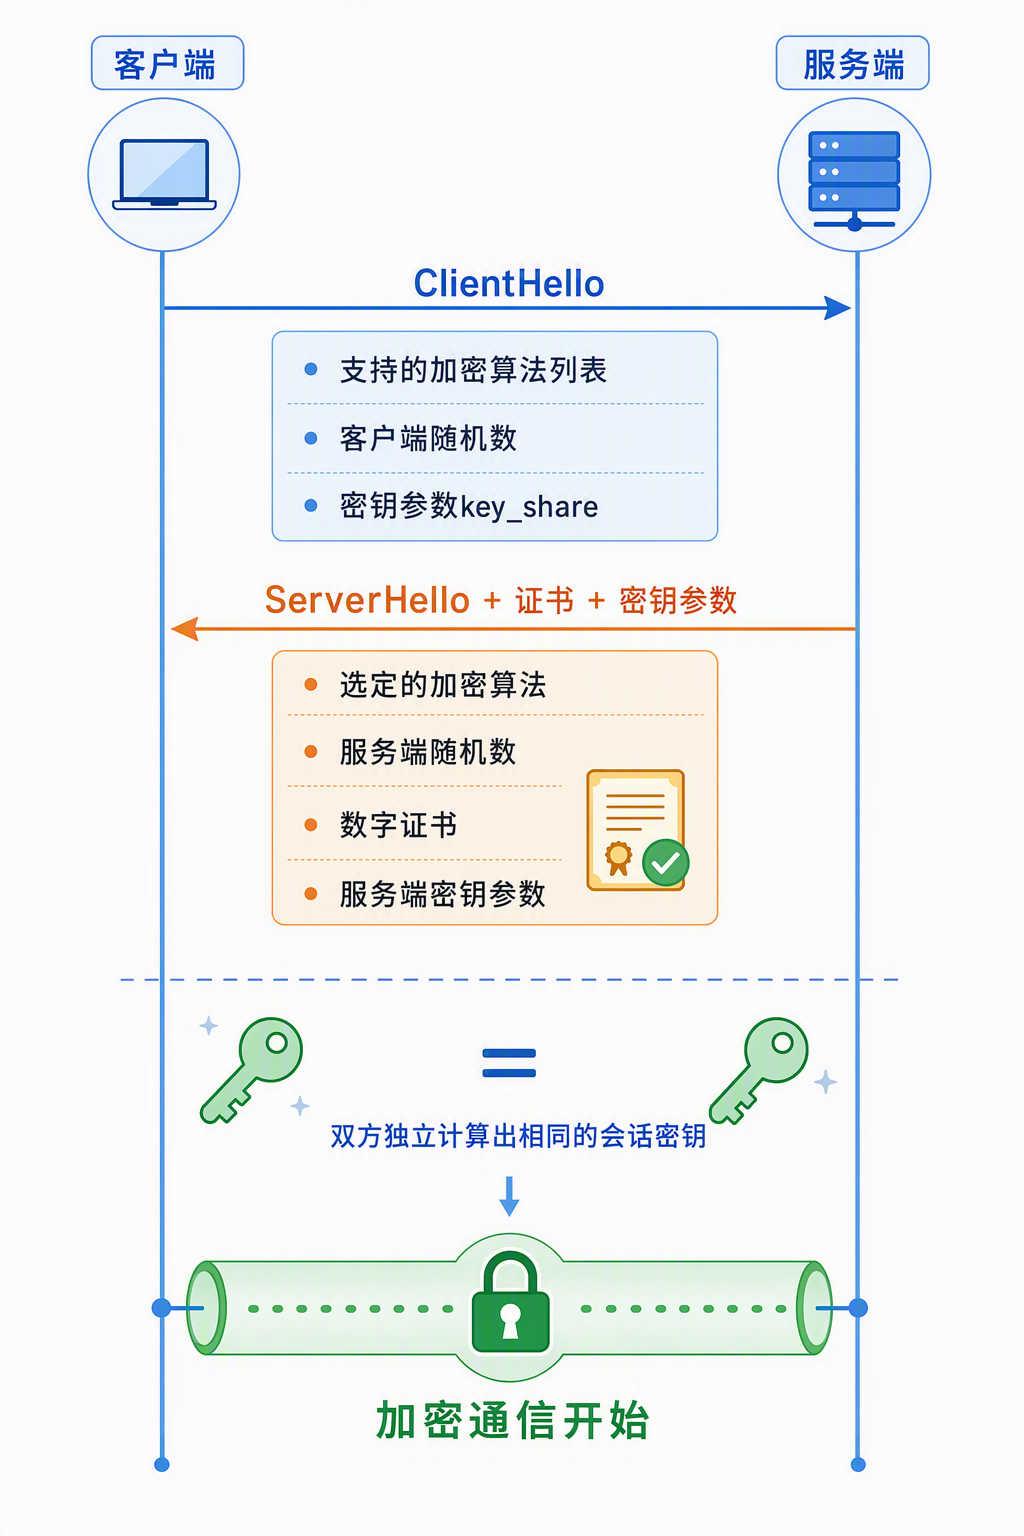
以目前主流的 TLS 1.3 为例,
- Client Hello,客户端跟服务端打招呼。「我支持这几种加密算法(比如 AES-256-GCM、ChaCha20-Poly1305),这是我生成的随机数,还有我预生成的一组密钥参数(基于椭圆曲线 X25519 或 P-256)。」TLS 1.3 的聪明之处在于,客户端在第一条消息里就把密钥参数带上了,不用等服务端先回复再发。
- Server Hello + 证书 + 密钥,服务端选定一套加密算法,附上自己的数字证书和密钥参数。「用 AES-256-GCM 吧。这是我的证书,证明我是真的 example.com,不是冒充的。」
- 客户端验证证书是否可信(通过内置的 CA 根证书链校验),验证通过后,双方各自用对方的密钥参数和自己的私钥,通过 ECDHE 算法计算出一个相同的「会话密钥」。这个密钥从来没有在网络上传输过,即使有人录下了整个握手过程,也算不出来。
- 加密通道建立。后续所有数据都用这个对称密钥加密传输。
TLS 1.3 比 TLS 1.2 快在哪?
TLS 1.2 需要 2 个 RTT 才能完成握手。客户端先发 ClientHello,服务端回 ServerHello + 证书,客户端验证证书后再发一轮密钥交换,服务端确认,然后才能发数据。来回两趟。
TLS 1.3 把密钥参数直接放在 ClientHello 里一起发过去,省掉了一趟。只需要 1 个 RTT。
更猛的是 0-RTT 恢复。如果客户端之前连过这个服务端,手里有上次的会话票据(Session Ticket),它在 ClientHello 里直接带上加密数据,服务端验证票据后直接处理。连一个 RTT 都不用等。当然 0-RTT 有重放攻击的风险,所以只适合幂等请求(比如 GET)。
证书是怎么验证的?
客户端收到服务端的证书后,做三件事,
- 查签名链。证书是某个 CA(证书颁发机构)签发的,CA 的证书又是更上级 CA 签的,一层层追溯到根 CA。浏览器内置了大约 150 个可信根 CA,只要链条完整且根 CA 在列表里,签名验证通过。你在 Chrome 的设置里能看到完整的根证书列表。
- 查域名。证书上写的域名(Subject Alternative Name 字段)必须跟你访问的域名一致。比如证书写的是
*.example.com,你访问www.example.com没问题,访问mail.other.com就不行。 - 查有效期。证书不能过期。现在 Let’s Encrypt 签发的免费证书有效期是 90 天,到期要续签。
三项全过,才认为这个服务端是可信的。任何一项不通过,浏览器就弹出那个你熟悉的「您的连接不是私密连接」警告页面。
盔甲穿好了。我身上的每一个字节都被 AES-256 加密保护着。
终于可以上路了。
我出发了,HTTP 请求
我长什么样?
大管家把我组装好了。我由三部分组成,
请求行,一行搞定最核心的信息。
1GET /index.html HTTP/1.1
方法(GET)+ 路径(/index.html)+ 协议版本。GET 就是「我来拿东西的」,POST 是「我带了东西要交给你」。
请求头,一堆 key-value 对,是我的身份证明和偏好声明。
1Host: www.example.com
2User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7)...
3Accept: text/html,application/xhtml+xml
4Accept-Encoding: gzip, br
5Accept-Language: zh-CN,zh;q=0.9,en;q=0.8
6Connection: keep-alive
7Cookie: session_id=abc123; theme=dark
8If-None-Match: "etag-xyz"
Host 告诉服务端我要找的是哪个域名(一台服务器可能托管了好几个网站)。User-Agent 是我的户口本,写了浏览器型号和操作系统。Accept-Encoding 告诉服务端我能解压 gzip 和 Brotli 压缩。Cookie 带着上次服务端给我的小纸条,用来证明「我上次来过」。If-None-Match 带着上次拿到的内容指纹(ETag),如果内容没变,服务端可以直接回一个 304,我就不用再搬一趟了。
请求体,GET 请求一般没有请求体。POST 请求会把表单数据或 JSON 放在这里。
整个我被 TLS 加密后,通过 TCP 连接发给服务端。从这一刻起,我正式踏上了征途。
HTTP/1.1、HTTP/2、HTTP/3 有什么区别?
这跟我能不能快点到达有很大关系。
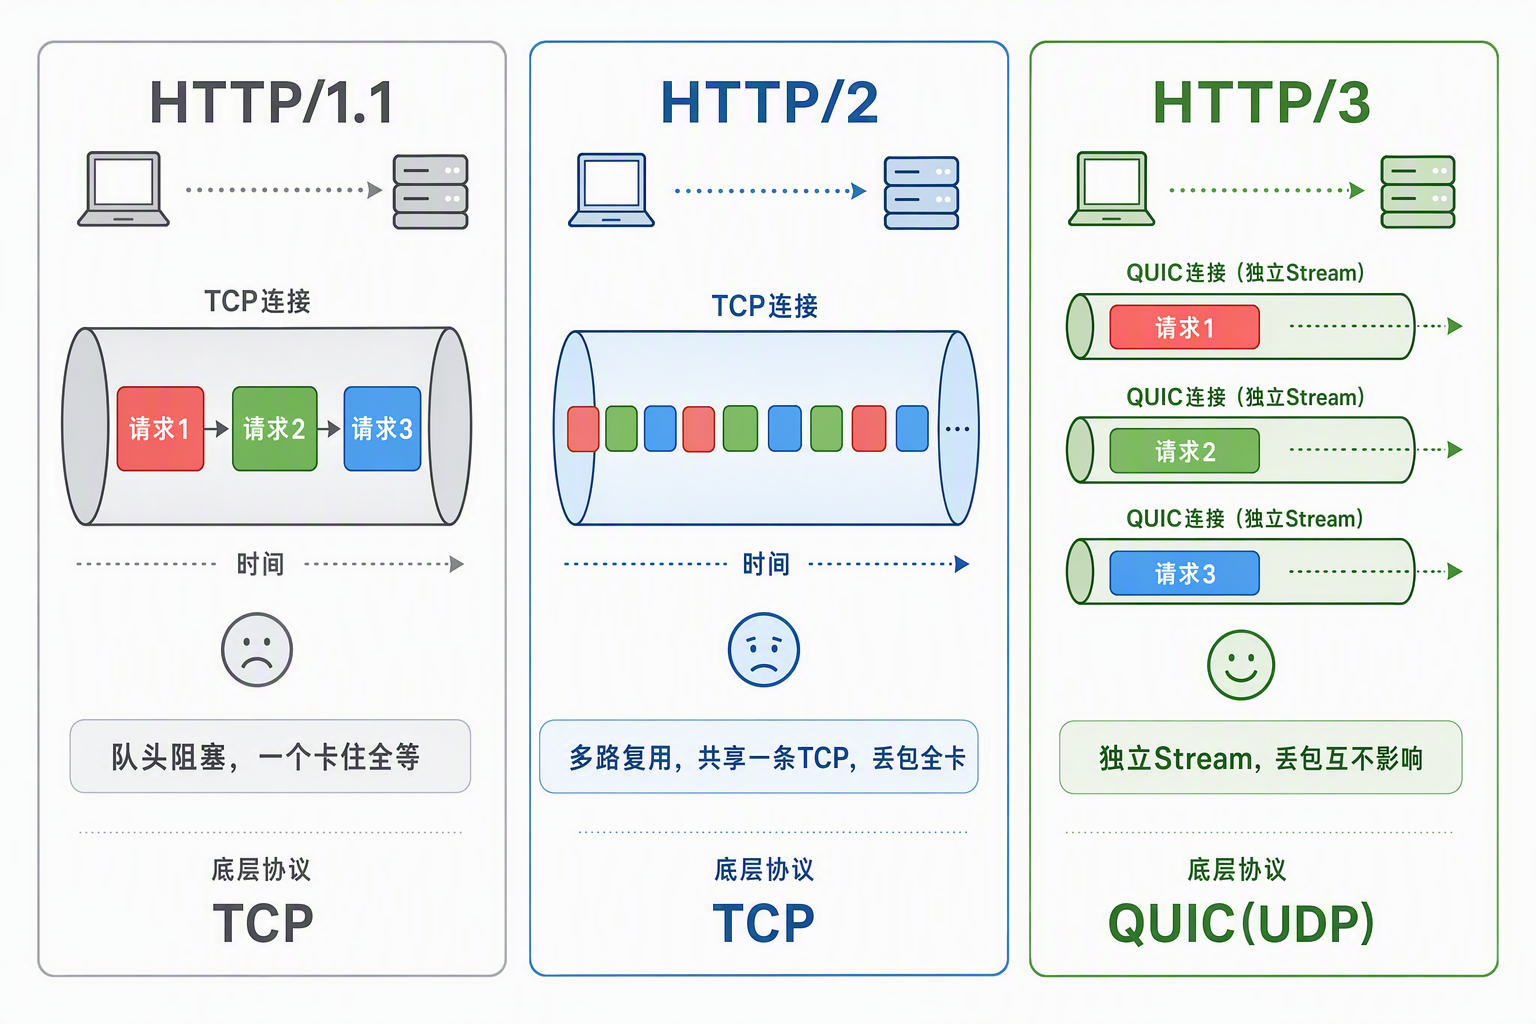
HTTP/1.1 是最基础的版本。一个 TCP 连接上同一时间只能处理一个请求。大管家要请求一个 HTML,必须等 HTML 返回了,才能请求 CSS。这就是队头阻塞。大管家的应对办法是同时开 6 个 TCP 连接,并行请求。但每个连接都要单独走一遍三次握手 + TLS 握手,开销不小。而且 HTTP/1.1 的头部是纯文本,同样的 Cookie 和 User-Agent 每次请求都要重新发一遍,浪费带宽。
HTTP/2 引入了多路复用。一个 TCP 连接上可以同时跑多个请求和响应,每个请求/响应被拆成帧(frame),帧上标了 Stream ID,交替发送,到了对面再按 ID 重新拼起来。不用排队了。而且 HTTP/2 用 HPACK 算法压缩头部,第一次发完整的头,后面只发跟上次不同的部分,头部体积能压缩 85% 以上。
但 HTTP/2 有一个问题没解决。它底层还是 TCP。TCP 有自己的队头阻塞,一个包丢了,TCP 会让整条连接上所有 Stream 都等着重传。一个人掉队,全队停下来等。
HTTP/3 干脆换掉了 TCP,用 QUIC 协议跑在 UDP 之上。QUIC 每个 Stream 独立重传,一个 Stream 丢包不影响其他 Stream。而且 QUIC 把 TLS 1.3 握手集成到了传输层握手里,连接建立只要 1 个 RTT(TCP + TLS 分开走要 2-3 个 RTT)。QUIC 还支持连接迁移,你从 WiFi 切到 4G,IP 地址变了,QUIC 靠连接 ID(不是 IP+端口)识别连接,不用重新握手。
我出发了。穿过你的网卡,经过家里的路由器,跑过运营商的骨干网,可能还跳了十几个路由节点。每经过一个路由器,路由器都要查自己的路由表,决定我下一跳该往哪走。就像在高速公路上,每到一个岔路口,都有一个指路牌告诉我往左还是往右。
终于,我到了目的地。
到了后厨,服务器处理
服务端收到我之后做了什么?
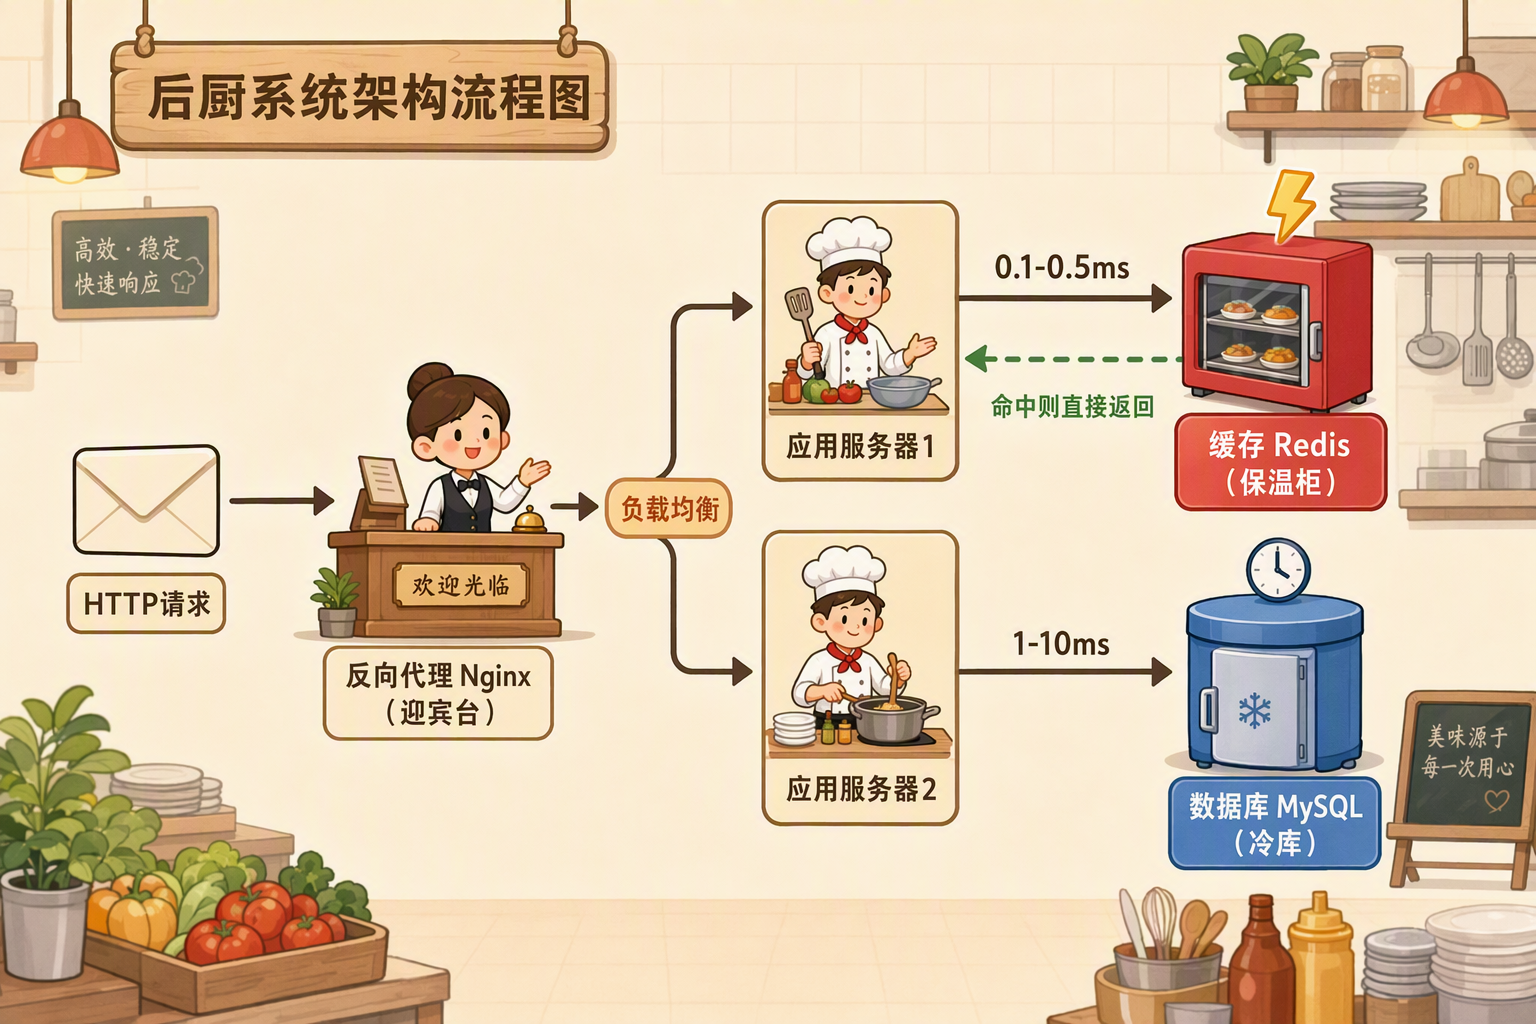
用餐厅来打比方。我就像一个外卖订单,从你手机发出来,到菜端上桌,中间要经过好几道工序。
第一道,反向代理(迎宾台)
我最先到达的往往是一个反向代理,比如 Nginx 或者云厂商的负载均衡器,应用服务器藏在它后面。反向代理相当于餐厅门口的迎宾台,负责把顾客领到合适的桌位。
迎宾台干的活不少,
- 把我转发给后面的应用服务器
- 如果有多台应用服务器,按策略分配(轮询、加权轮询、IP 哈希、最少连接数)
- 做 SSL 终止(TLS 在这里解密,后面走内网明文,降低应用服务器压力)
- 静态文件直接返回,不用打扰后厨(Nginx 处理静态文件的速度比 Node.js 快一个数量级)
- 缓存热点内容(配上
proxy_cache之后,同一个请求第二次来就不用再跑到后面了) - 限流和防护(防 DDoS、限制单 IP 请求频率)
第二道,应用服务器(厨师)
我到了应用服务器,开始执行业务逻辑。比如你访问的是一个电商首页,应用服务器需要,
- 解析我的 Cookie 或 Authorization 头,验证你的登录状态
- 根据你的用户画像拉取推荐商品列表(可能要调推荐服务的 API)
- 拉取购物车信息
- 把这些数据塞进模板,组装成 HTML,或者直接返回 JSON(前后端分离的架构)
第三道,数据库和缓存
应用服务器需要数据的时候,有两个地方可以找。
缓存(保温柜),热门数据会放在 Redis 或 Memcached 里。查一次 Redis 大概 0.1-0.5ms,比查数据库快 100 倍。应用服务器先查缓存,有就直接用。
数据库(冷库),缓存没命中才去查 MySQL 或 PostgreSQL。一条普通的索引查询大概 1-10ms,复杂的联表查询可能要几十甚至几百毫秒。查完把结果写一份到缓存里方便下次用。
服务器给我的回信长什么样?
服务器处理完我带来的请求后,把结果打包成 HTTP 响应,原路返回。
响应也是三部分,
状态行,
1HTTP/1.1 200 OK
状态码是一个三位数,代表处理结果,
| 范围 | 含义 | 常见的 |
|---|---|---|
| 1xx | 信息提示 | 100 Continue |
| 2xx | 成功 | 200 OK,201 Created |
| 3xx | 重定向 | 301 永久搬家,302 临时搬家,304 缓存还能用 |
| 4xx | 客户端的锅 | 400 格式不对,403 没权限,404 找不到,429 请求太多 |
| 5xx | 服务端的锅 | 500 内部爆炸,502 上游挂了,503 忙不过来 |
响应头,
1Content-Type: text/html; charset=utf-8
2Content-Encoding: br
3Content-Length: 38291
4Cache-Control: max-age=3600
5ETag: "abc123"
6Set-Cookie: session_id=xyz789; HttpOnly; Secure
7Strict-Transport-Security: max-age=31536000
Content-Type 告诉浏览器返回的是 HTML。Content-Encoding: br 说明用 Brotli 压缩过了,浏览器拿到后先解压。Cache-Control 告诉浏览器这个响应可以缓存 3600 秒。ETag 是内容指纹,下次请求同一个地址时浏览器会带上它(If-None-Match),服务端比对后如果内容没变就回 304,省流量。Set-Cookie 给浏览器塞了一张小纸条,下次我出门的时候要带上。
响应体,就是实际的内容。如果请求的是一个网页,响应体就是一大段 HTML。
我带着这堆宝贝原路跑回来了。穿过骨干网,经过路由器,回到你家的网卡,交给操作系统,操作系统再交给浏览器大管家。
大管家收到 HTML 了。但一堆代码还不是你能看的东西。
接下来是整趟旅程里最复杂的部分。
装修工人开工,浏览器渲染
浏览器拿到 HTML 后怎么变成你看到的页面?
大管家把我带回来的 HTML 交给了渲染引擎。Chrome 用的是 Blink,Firefox 用的是 Gecko,Safari 用的是 WebKit。渲染引擎就像一个装修工人团队,每个工种各干一段,流水线作业。
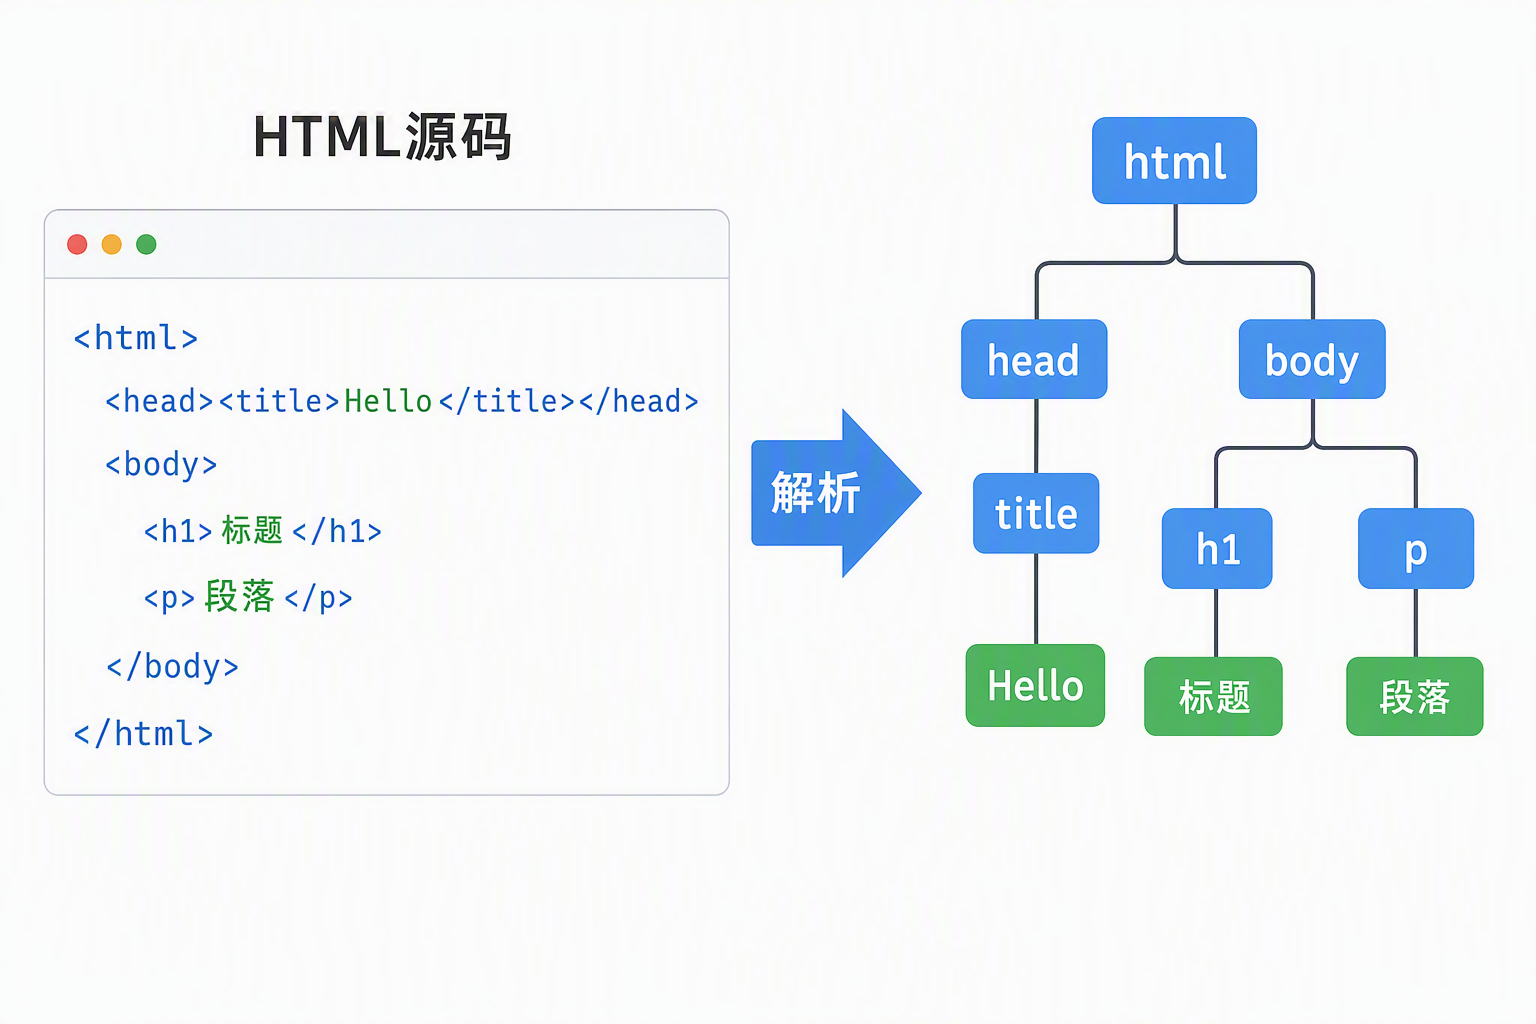
第一步,解析 HTML 构建 DOM 树。
渲染引擎从上到下读 HTML,每遇到一个标签就创建一个节点,按嵌套关系组织成一棵树。
比如这段 HTML,
1<html>
2  <head><title>Hello</title></head>
3  <body>
4    <h1>标题</h1>
5    <p>段落</p>
6  </body>
7</html>
会被解析成,
1html
2├── head
3│   └── title → "Hello"
4└── body
5    ├── h1 → "标题"
6    └── p → "段落"
解析器是增量式的,不用等整个 HTML 下载完才开始,收到一部分就解析一部分。这也是为什么你打开一个大网页时,能看到内容一段一段地出现。
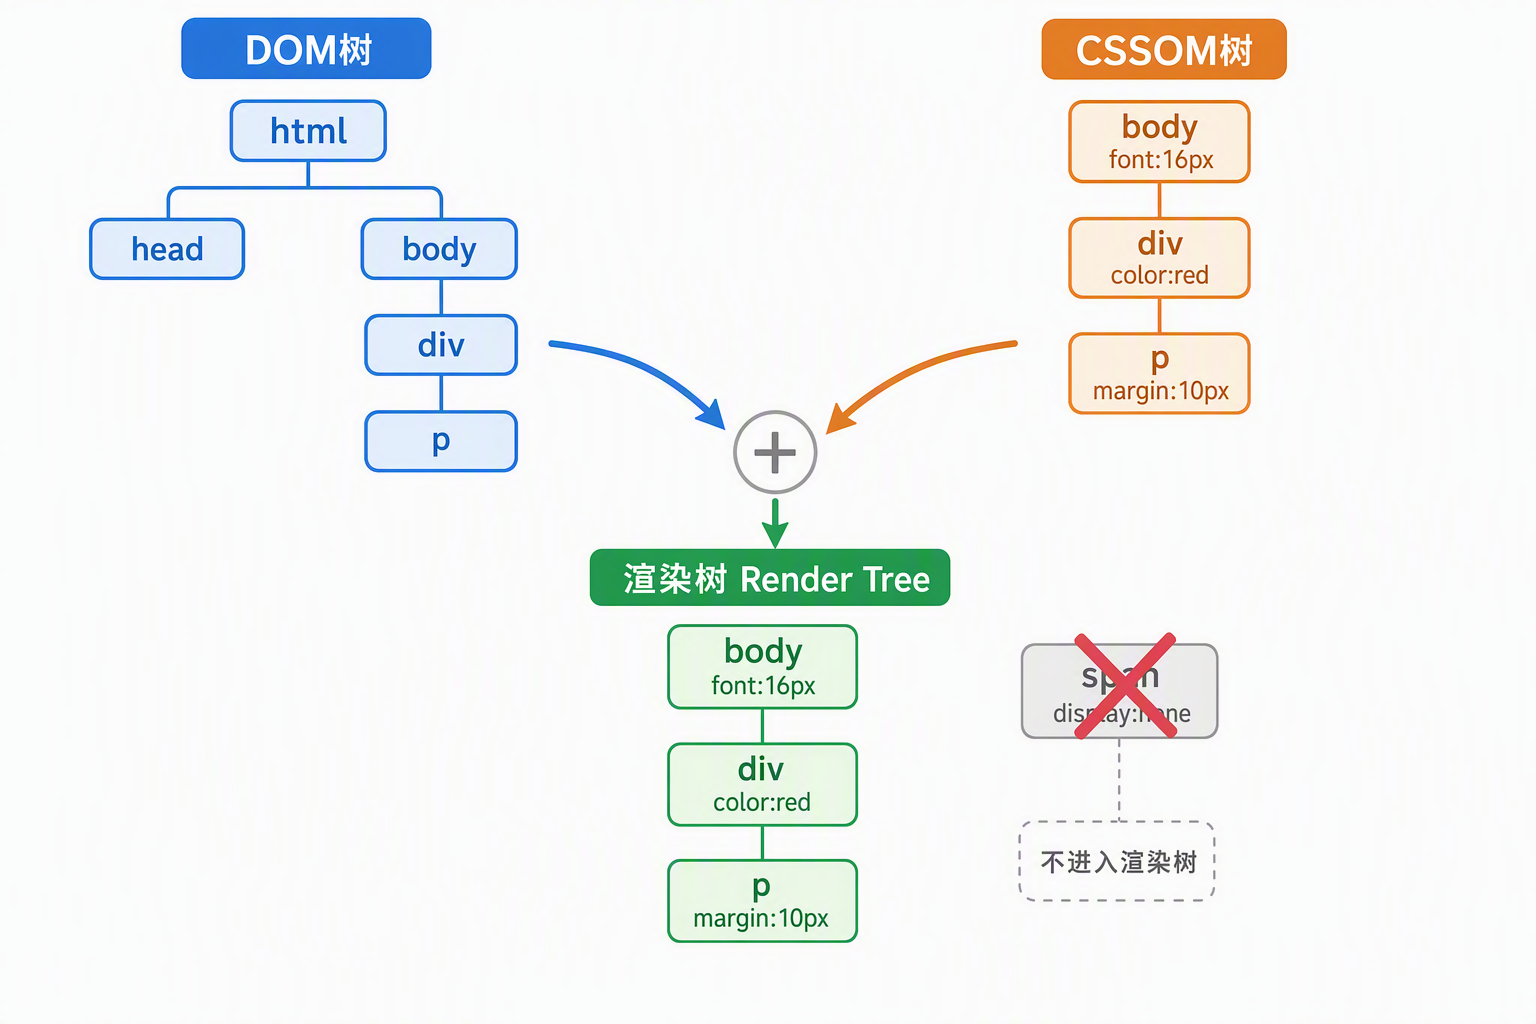
第二步,解析 CSS 构建 CSSOM 树。
HTML 里引用的 CSS 文件(<link> 标签)或者内联样式也要解析。CSS 同样被组织成一棵树,叫 CSSOM(CSS Object Model)。每个节点记录了对应元素的样式规则。CSS 解析不会阻塞 DOM 解析,但会阻塞渲染,因为没有样式信息就没法画页面。
第三步,合并生成渲染树(Render Tree)。
DOM 树 + CSSOM 树合并,生成渲染树。渲染树只包含需要显示的节点。<head> 标签、<script> 标签、display: none 的元素都不会出现在渲染树里。visibility: hidden 的元素会出现(它只是看不见,但还占位置)。
遇到 JavaScript 怎么办?
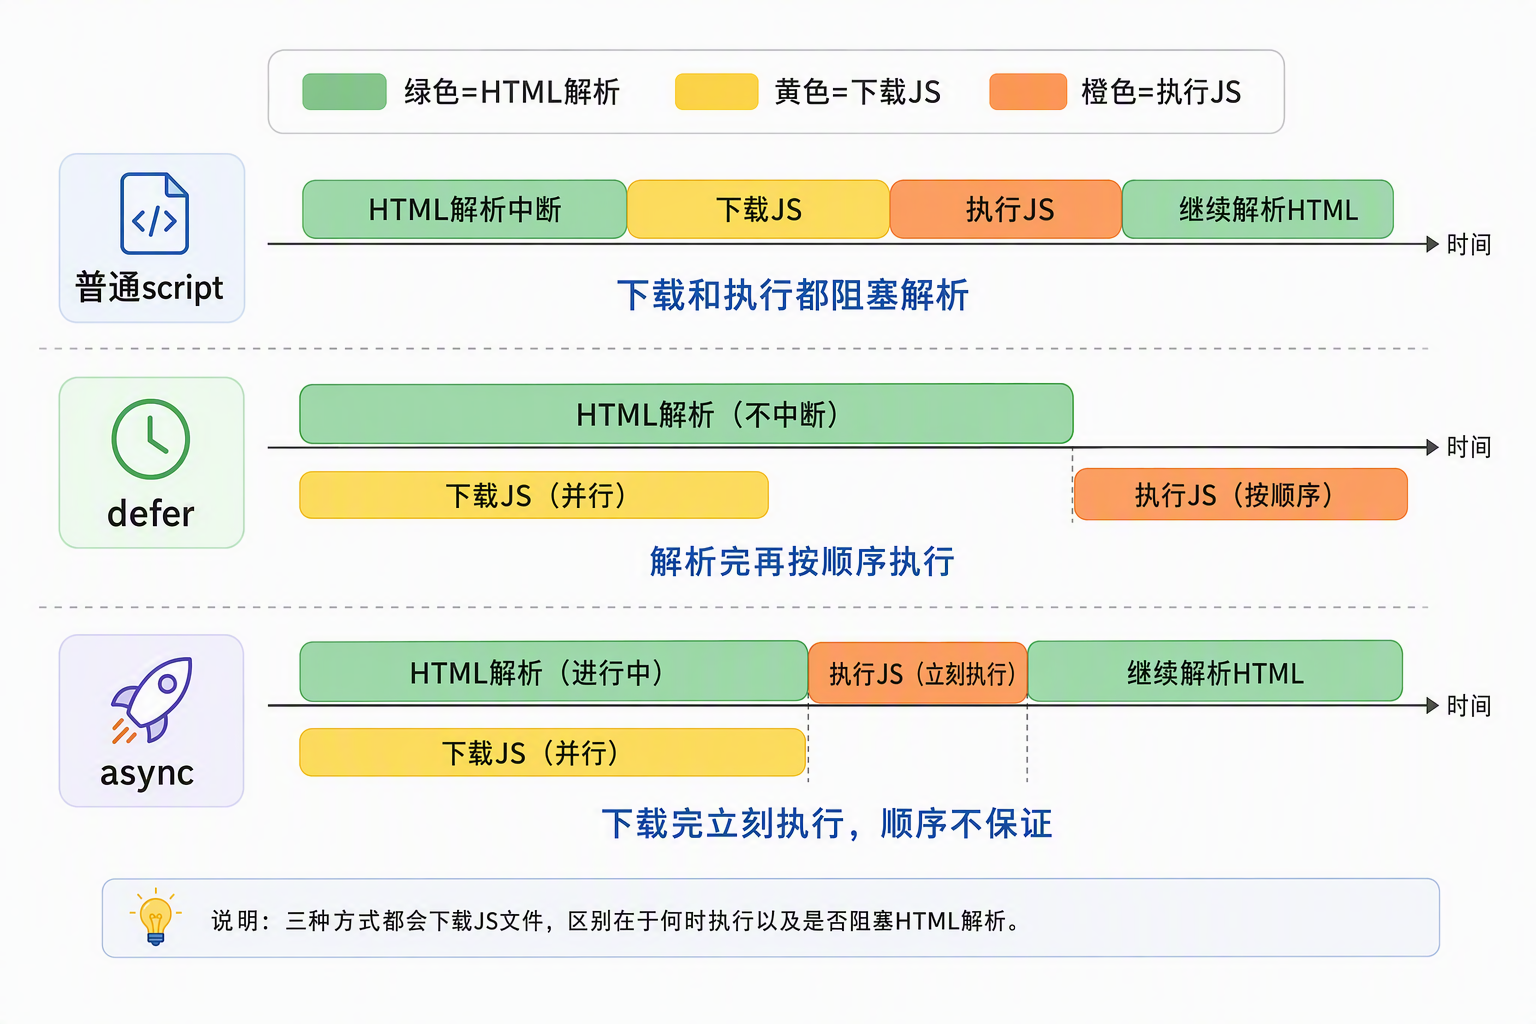
HTML 解析过程中如果遇到 <script> 标签,浏览器会暂停 HTML 解析,去下载并执行 JavaScript。因为 JS 可能会修改 DOM 结构(比如 document.write),浏览器必须等 JS 执行完才能继续。这就是为什么一个写得不好的 script 标签能让页面卡半天。
解决方案是给 script 标签加属性,
defer,HTML 解析不暂停,JS 文件在后台并行下载,等 HTML 全部解析完后再按出现顺序执行。适合大多数场景。async,HTML 解析不暂停,JS 文件并行下载,但下载完立刻执行(可能打断 HTML 解析,执行顺序不保证)。适合独立的第三方脚本,比如 Google Analytics。
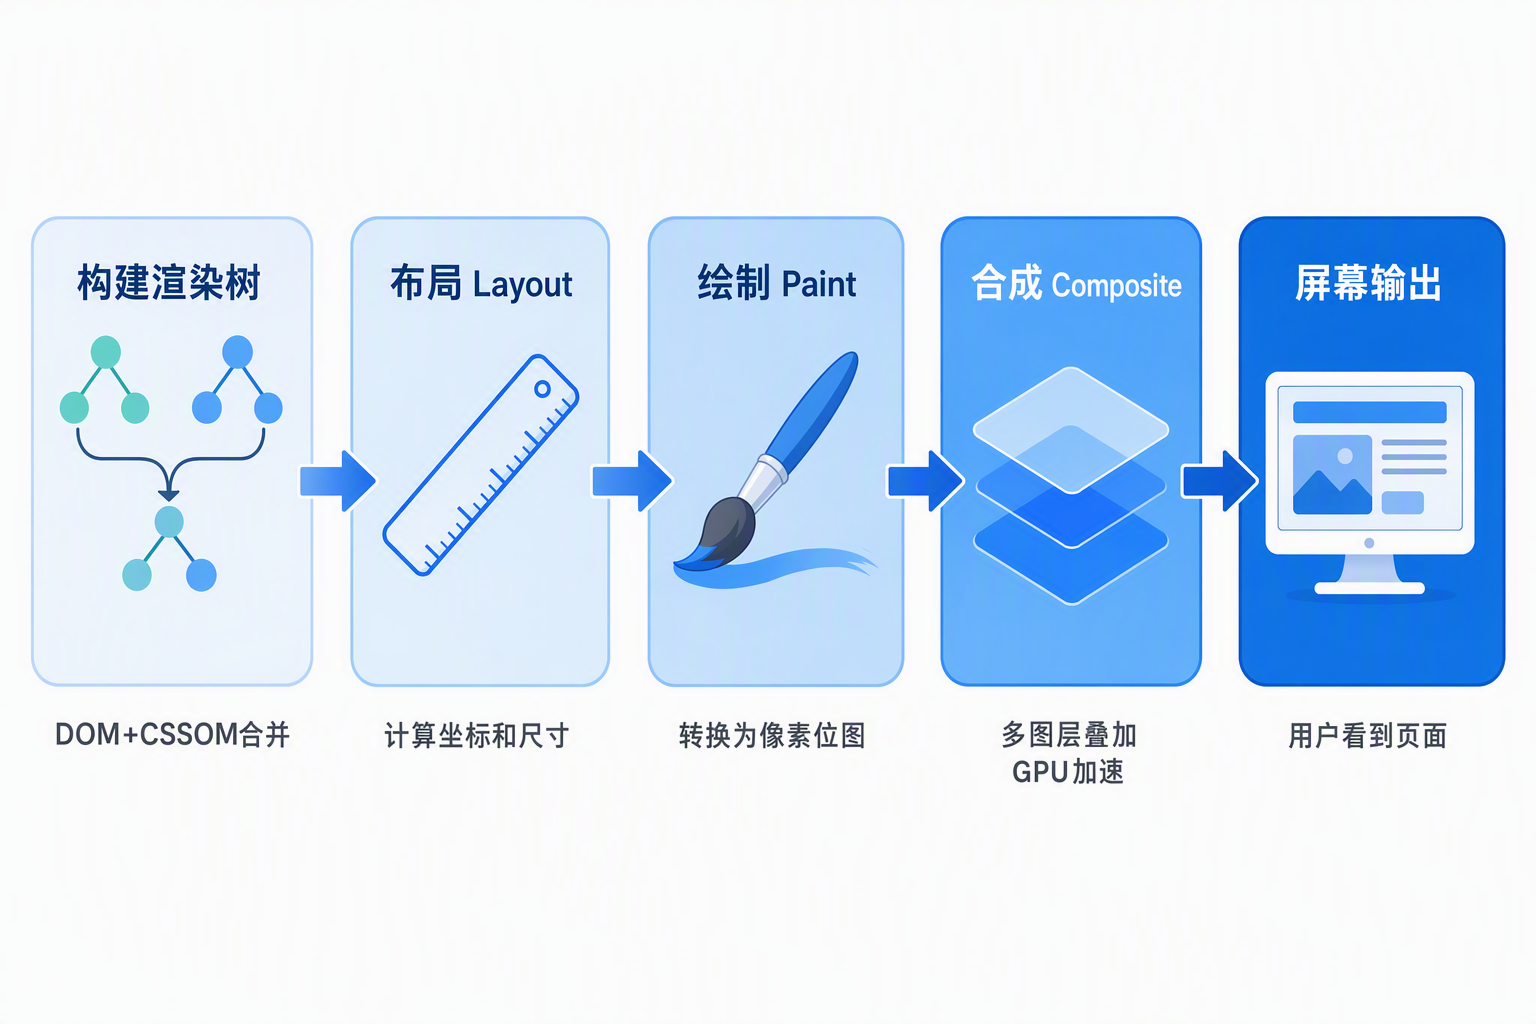
渲染树建好了,怎么画到屏幕上?
第四步,布局(Layout / Reflow)。
渲染树里每个节点知道自己的样式,但不知道自己在屏幕上的位置和大小。布局阶段就是算出每个节点的几何信息,坐标 (x, y) 和尺寸 (width, height)。一个 <div> 设置了 width: 50%,浏览器要根据父容器的宽度算出实际像素值。窗口 1000px 宽,那它就是 500px。这个计算是递归的,从根节点开始,一层层往下算。
第五步,绘制(Paint)。
布局算完了,开始画。浏览器按照渲染树的顺序,把每个节点的内容转换成绘制指令,记录到一个绘制列表(Paint Records)里。文字用什么字体什么颜色画在什么位置、背景色填什么、边框画多粗、阴影怎么投、图片贴在哪,全部变成一条条具体的绘制指令。
第六步,合成(Composite)。
现代浏览器会把页面分成多个图层(Layer)。比如一个 position: fixed 的导航栏是一个独立图层,带 transform 或 will-change 的元素也会被提到独立图层。合成阶段把所有图层的绘制结果交给 GPU,GPU 按照正确的顺序叠在一起,输出到屏幕。图层分离的好处是,当你滚动页面时,固定的导航栏不用重新绘制,只需要移动主体图层的位置,GPU 重新合成就行了。非常快。
什么时候会触发重排和重绘?
重排(Reflow),改变了元素的几何属性(大小、位置、显隐),浏览器要从布局阶段重新来一遍。比如你用 JS 改了一个 div 的宽度,整个布局可能都要重新计算。代价最大。
重绘(Repaint),只改了样式但没改几何属性(比如改了颜色、改了背景图),浏览器跳过布局,直接从绘制阶段重新来。代价比重排小。
最经济的操作,只触发合成。 CSS 的 transform 和 opacity 变化不触发重排也不触发重绘,直接在合成阶段由 GPU 处理。这就是为什么做 CSS 动画优先用 transform 而不是 top/left。一个走 GPU 合成线程,一个要走主线程的布局和绘制,性能差了一个量级。
页面渲染完了。你看到了网页。
我的任务完成了。
挂电话,TCP 四次挥手
数据传完了,TCP 连接怎么断开?
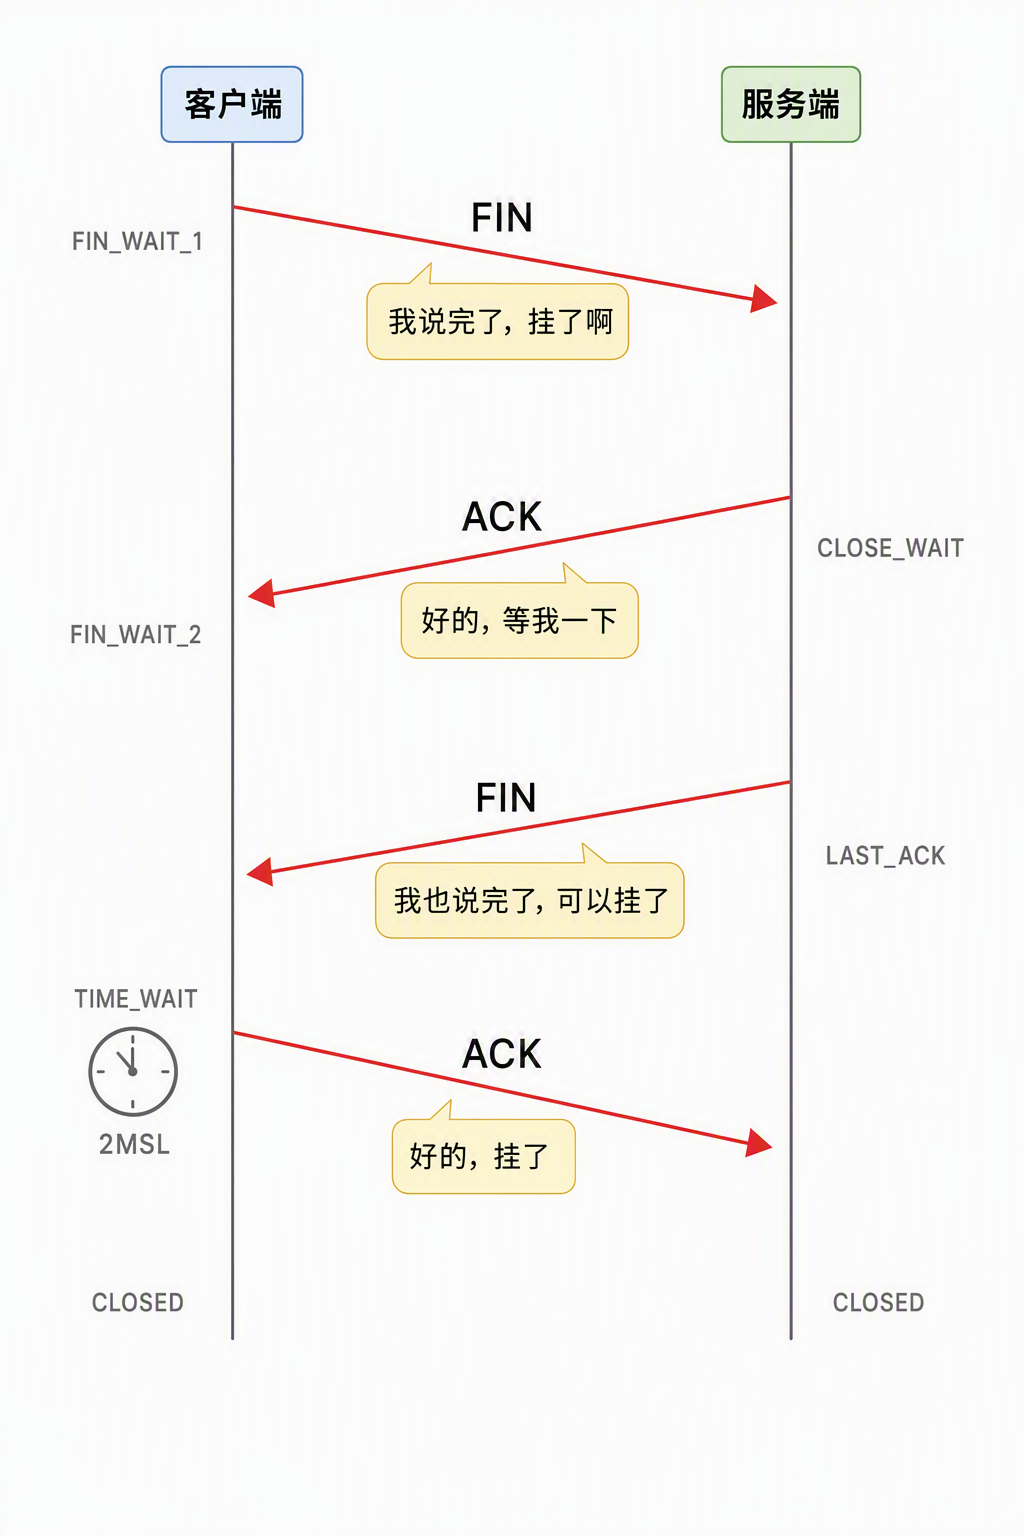
TCP 断开连接用的是四次挥手。还是用打电话的比方,
- 客户端说,「我说完了,挂了啊。」(发送 FIN 包,进入 FIN_WAIT_1 状态)
- 服务端说,「好的,我知道你说完了。不过我这边可能还有话没说完,等我一下。」(回复 ACK,进入 CLOSE_WAIT 状态。客户端收到后进入 FIN_WAIT_2)
- 服务端把剩下的数据发完之后说,「我也说完了,可以挂了。」(发送 FIN 包,进入 LAST_ACK 状态)
- 客户端说,「好的,挂了。」(回复 ACK,进入 TIME_WAIT 状态,等 2MSL 后关闭)
为什么挥手要四次不是三次?
因为 TCP 是全双工的。客户端说「我说完了」只代表客户端不再发数据了,但服务端可能还有数据没发完。所以服务端先回一个 ACK 表示「知道了」,等自己的数据发完了,再发 FIN 表示「我也说完了」。这两步不能合并,因为中间可能隔了好几秒甚至更久。
如果服务端在收到 FIN 的时候恰好也没数据要发了,第二步的 ACK 和第三步的 FIN 可以合并成一个包(这叫延迟确认),这样就变成三次。但四次是通用情况。
TIME_WAIT 是怎么回事?
客户端发完最后一个 ACK 后,不会立刻关闭连接,而是进入 TIME_WAIT 状态,等 2 倍的最大报文生存时间(2MSL,Linux 默认 60 秒)。
为什么要等?两个原因,
- 万一最后那个 ACK 丢了,服务端会重发 FIN,客户端需要还在,能重发 ACK。
- 等待期间可以让网络中残留的旧数据包消亡,防止它们被新连接收到造成混乱。
高并发服务器上 TIME_WAIT 连接太多会占端口,可以通过 tcp_tw_reuse(复用 TIME_WAIT 连接)来优化,但 tcp_tw_recycle 在 NAT 环境下有坑,Linux 4.12 以后已经被移除了。
实际上每次都要断开重连吗?
不是。浏览器和服务端通常用 Keep-Alive 机制,一个 TCP 连接上跑多个 HTTP 请求,不会每次都重新握手再挥手。HTTP/1.1 默认开启 Keep-Alive,HTTP/2 更是只用一个连接跑所有请求。所以真正的四次挥手只发生在连接空闲超时或者页面关闭的时候。
我的旅程回顾
咱们把这一整趟串起来看一遍,
- 大管家拆 URL,判断输入、检查 HSTS、翻缓存
- DNS 问路,浏览器缓存 → OS 缓存 → hosts → 本地 DNS → 根 DNS(老大)→ 顶级域 DNS(老二)→ 权威 DNS(老三)
- TCP 三次握手,建立可靠连接,确认双方都能通信
- TLS 握手,协商加密算法、交换密钥参数、验证证书
- HTTP 请求出发,我带着请求行、请求头、Cookie 上路
- 服务器处理,反向代理分发 → 应用服务器跑业务 → 查缓存 / 查数据库
- HTTP 响应回来,状态码 + 响应头 + HTML/JSON
- 浏览器渲染,HTML → DOM 树,CSS → CSSOM 树,合并成渲染树 → 布局 → 绘制 → 合成
- TCP 四次挥手,连接断开(或 Keep-Alive 保持)
整个过程我画成了一个图,
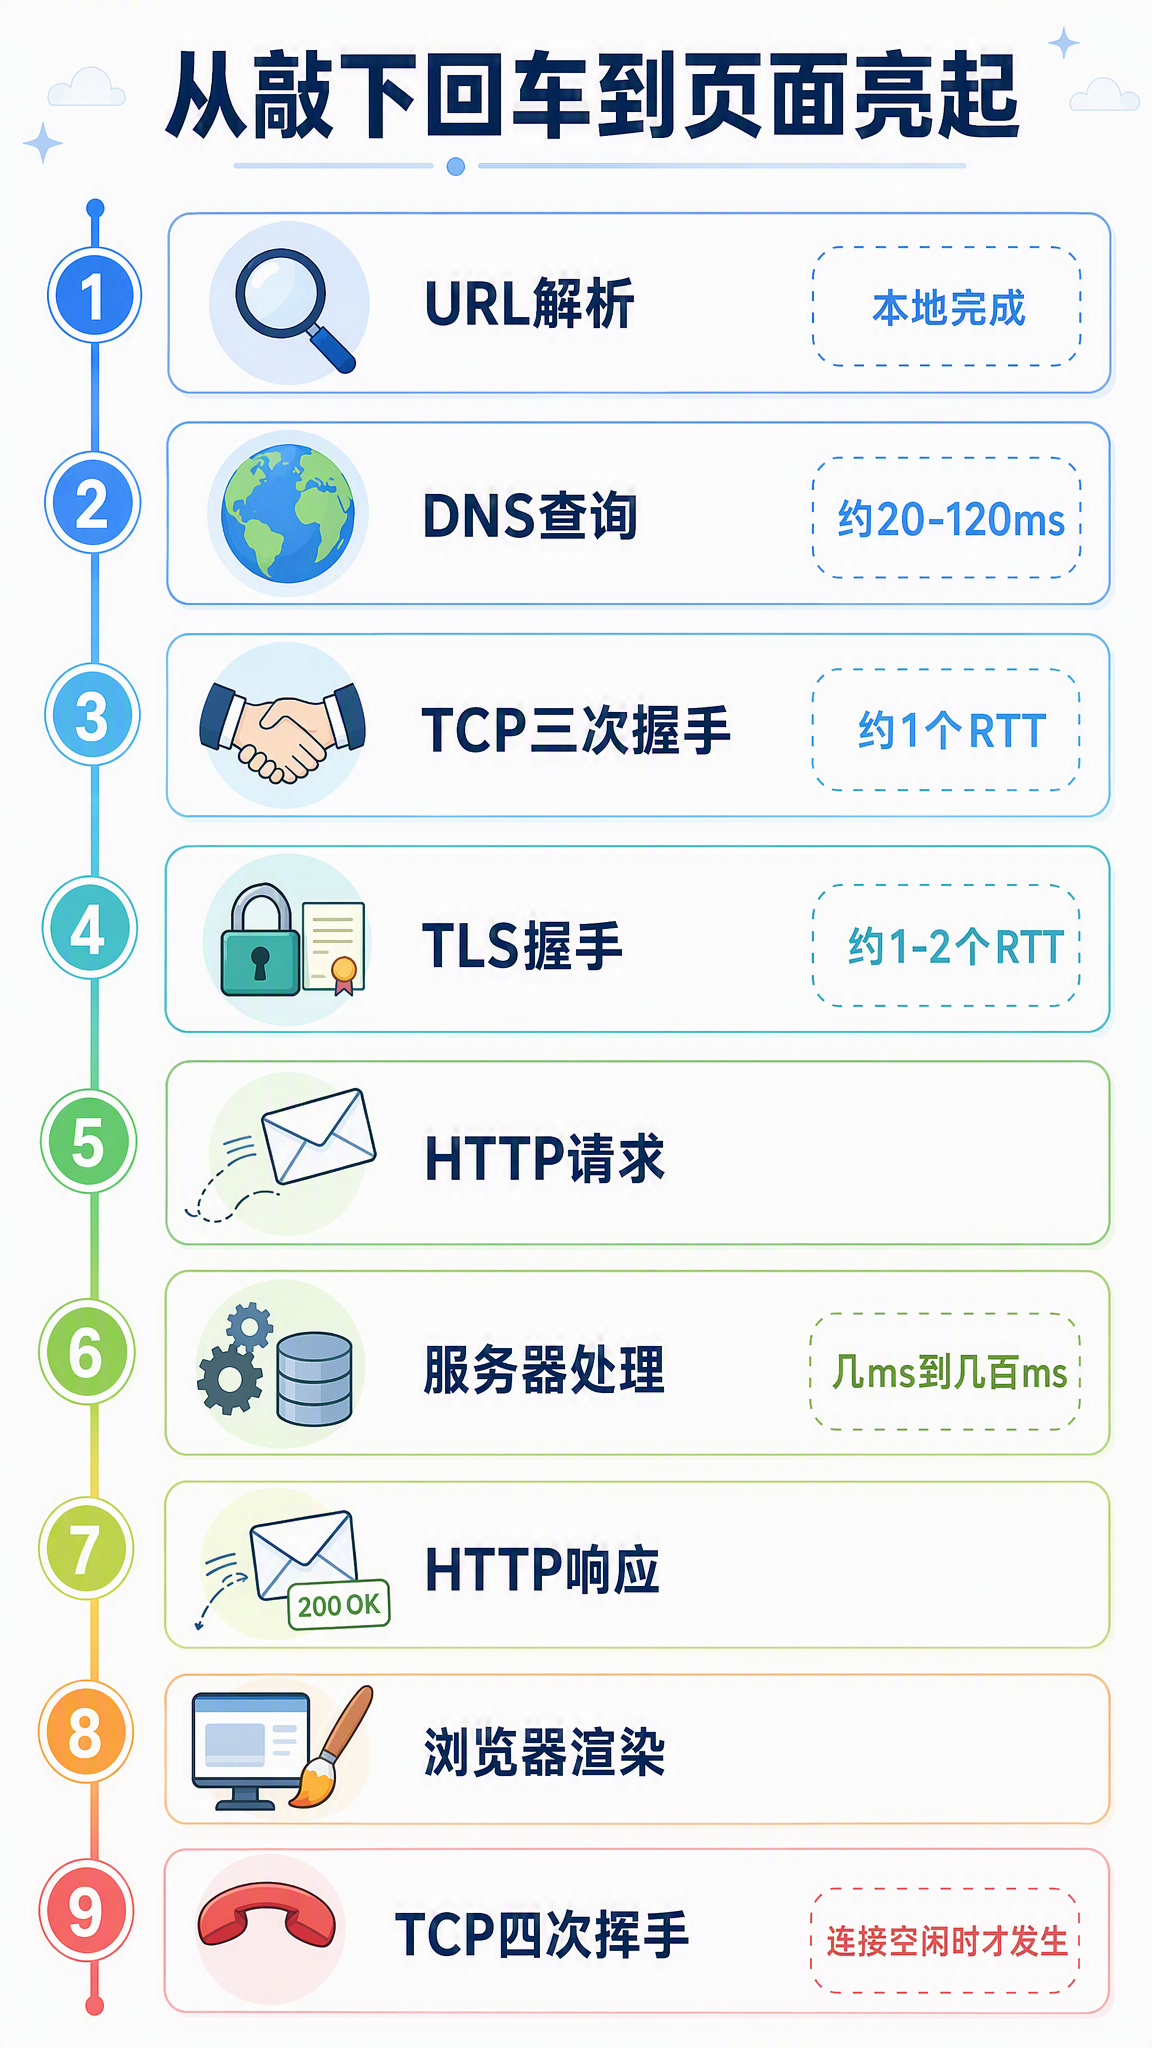
你看,从你敲下回车到页面亮起来,我经过了 DNS 的指路、TCP 的放行、TLS 的加密、网络的传输、服务器的处理、再原路跑回来交给渲染引擎画出页面。
这一趟通常只需要几百毫秒。快的时候你根本感觉不到等待。
但这几百毫秒里,有上百个组件在配合,有十几种协议在运转,有几十个路由节点在接力。任何一个环节出问题,你看到的就是白屏或者转圈。
下次面试官再问你这道题,你就把我的旅程从头到尾走一遍。DNS 用什么协议,TCP 为什么三次,TLS 1.3 快在哪,HTTP/2 的多路复用怎么回事,浏览器渲染的几个阶段,每一个点都能展开讲。
不怕他追问。追到哪一层,你就在哪一层稳稳接住他,哈哈。