代码改到第 8 轮,右下角上下文用量条直接红爆了。
这时候你手忙脚乱敲了个「/compact」,心里还琢磨着,这发摘要压缩下去,好歹能给会话回满血,把剩下两个接口写完。
然后你就迎来了最血压升高的场面。
模型没有满血复活,反而开始原地装傻。前两分钟刚跟你对齐的函数入参它全忘了,重要的类型边界被它悄悄吃掉,甚至拿着报错信息在原地无限打转。最后你坐在屏幕前深吸一口气,骂骂咧咧地把窗口关了,复制出几十行代码,老老实实重开一局。
我之前一直纳闷,为什么无论是 Cursor、Codex 还是 Claude Code,这个号称「拯救长会话」的压缩功能,用起来总像在给代码下毒。
直到我最近去翻 OpenAI 的底层提交记录。
我才发现官方早就看这玩意不爽了。
从 6 月底的一个关键 PR 开始,「/compact」的名字虽然还在,但里面的底层实现已经被他们完全掏空。它根本不再做任何摘要提取,只要一触发,背地里干的其实是清空当前窗口,给你硬切一个空窗口重开。
翻开提交链,官方早就动手了
去翻 OpenAI 最近两个月的核心代码仓,能清晰看到一条密谋已久的换代路线图。
| 时间 | PR | 关键改动 |
|---|---|---|
| 06-10 | #27438 / #27488 | 注入 token 预算,25%、50%、75% 阶梯提醒,加 new_context 工具让模型可主动开新窗 |
| 06-11 | #27518 | 增加 get_context_remaining,模型第一次被允许自查自己的剩余资源 |
| 06-23 | #29743(转折点) | /compact 与自动压缩不再做摘要,统一改为清窗重开,接口保留,实现掏空 |
| 07-15 | #33243 / #33255 | 增加切窗前的缓冲时间,让模型在清空前有时间写下便签笔记 |
| 08-21 | #39827 | 正式落地 notes(跨窗口私有笔记)与 history(全文搜索与按 ID 精确取回) |
| 08-31 | #41743 | 转录数据接入云端后端做全局索引 |
更有意思的是,这套改动不是命令行工具自己瞎搞,而是直接落在了整个客户端共享的「codex-rs/core」核心层和「app-server」通信协议里。CLI、IDE 插件、桌面端,全线一起换。
目前这套新架构由「Feature::TokenBudget」开关卡着,还在灰度推进。说白了,这就是经典的「先把实现偷梁换柱,等跑稳了再把旧接口扬了」。
摘要压缩到底错在哪了?
你想想看,写代码和写小说不一样。
写小说做摘要,丢掉两句景色描写无所谓。但写代码最要命的就是那些冷僻细节,比如一个隐藏的入参顺序,或者某个第三方库稀奇古怪的报错类型。
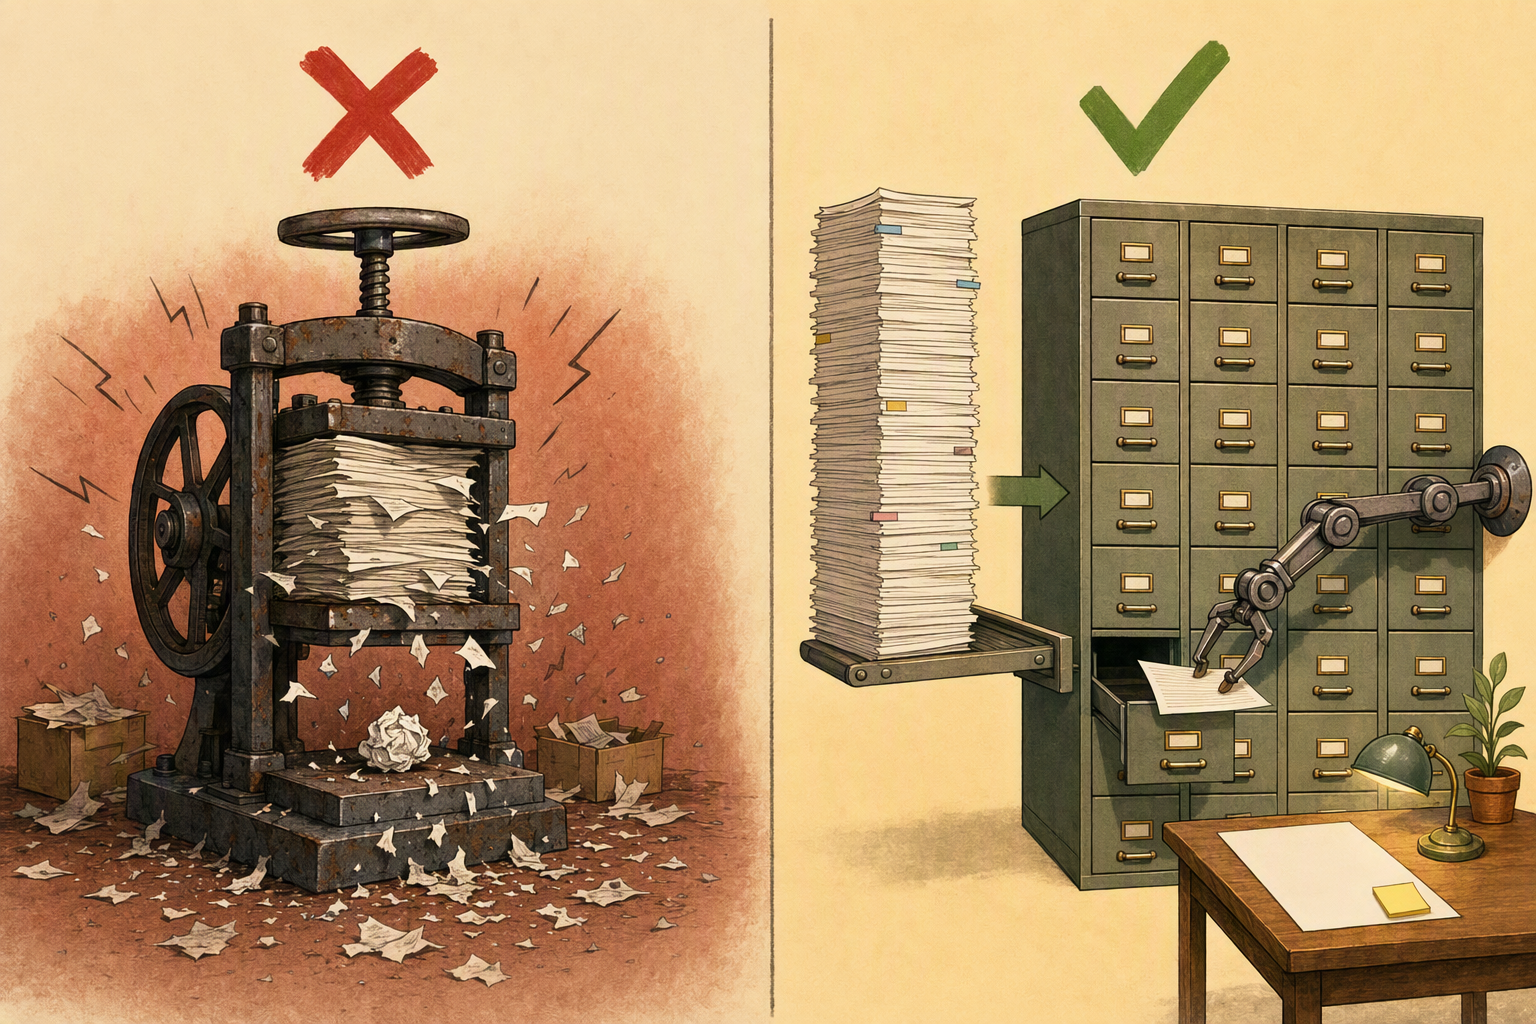
让模型去做摘要压缩,相当于逼它在还不知道未来哪行代码会报错的时候,去猜「什么东西该留下来」。
这怎么可能猜得准?
一次压缩丢点参数,两次压缩丢点边界条件,三轮下来,剩下的摘要就跟公司年终 PPT 一样,看着结构完整,真拿去跑全是 Bug。
而且做一次摘要压缩,本身就是一次拉满全窗口的重度推理。钱烧得飞快不说,很多时候模型还会因为上下文太长,自己把自己绕进死循环,直接把整个会话干报废。
硬切新窗口就不一样了。硬切只是在代码里清空一个数组,失败率直接是零。
所以 OpenAI 的思路彻底变了,别去猜未来需要什么,先把窗口清干净,等真的撞到问题了,让模型自己回头去查。
新架构怎么玩,操作系统的内存分级
看懂他们现在正在搭的这套新架构,你会发现他们把计算机操作系统的内存分级给搬过来了。
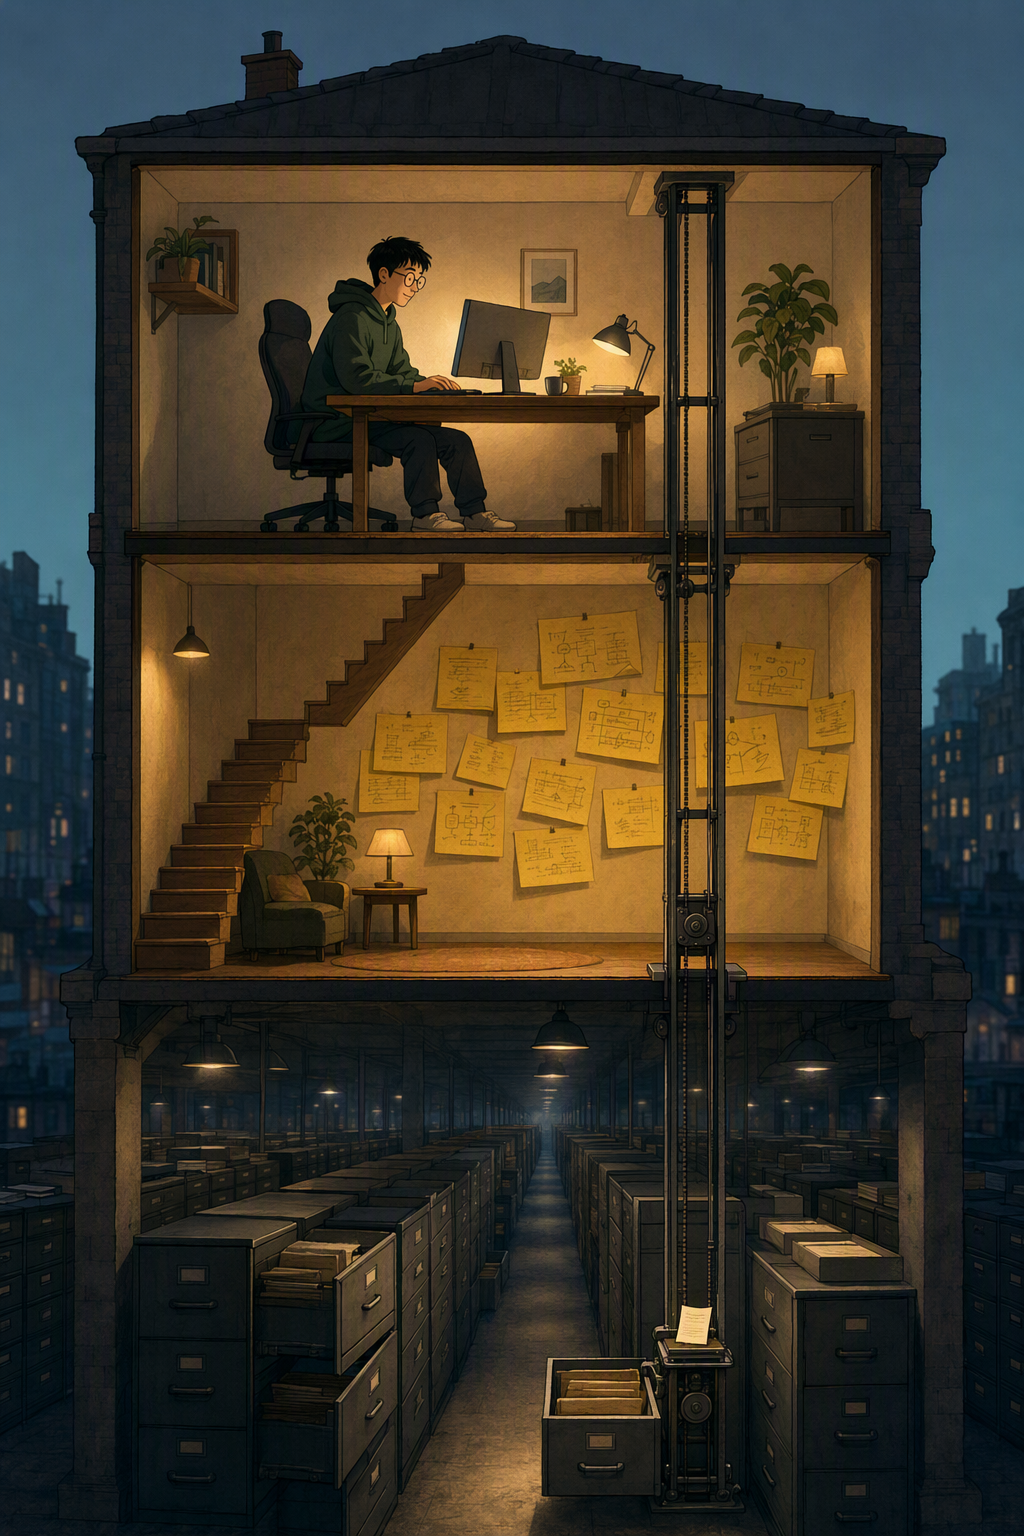
直接给大模型划分了三块地盘。
当前聊天的窗口,就是电脑的内存条(RAM)。空间寸土寸金,只放当下干活需要的那几屏代码,绝不留陈年老账。
旁边开个叫 notes 的便签,充当临时工作台。窗口快满的时候,系统给模型留出短暂的时间,把核心目标、当前进度和关键决策写在便签上。
最底下是 history 历史档案,相当于电脑的冷存储硬盘。你每一次输入的 Prompt、每一次报错、每一行生成的代码,都打上唯一 ID 扔进档案库。

窗口满了?直接内存清零,硬切到一个新窗口。
新窗口里只带走那张写着要点的便签。如果模型写着写着,发现需要查半小时前改过的那个数据结构,它不会把整座历史大山搬回内存,而是直接去冷存储里,按 ID 把那一条原始记录精准取回来。
把「瞎猜要留什么」,彻底变成了「按需检索精准调取」。
这套设计在 2023 年 MemGPT 论文里就有人提过,但当时大家只能靠在 Prompt 里拼命祈祷模型听话。现在 OpenAI 凶残的地方在于,他们直接把何时开窗、怎么记笔记、何时查历史,给训成了模型的出厂本能。
知道了这个,我们写代码该怎么做?
看清官方的底牌,我们在日常开发中就不用再跟上下文死磕了。
千万别再迷信会话里的自动压缩。任何复杂需求,尽量拆解成能在单窗口内闭环的小任务,依然是目前写出高质量代码的上限。
换新任务就果断开新会话。旧代码留在会话里只会变成检索时的噪声污染,随时可能把模型带偏。
真正关键的铁律和架构约束,老老实实写进本地的项目规则文件里。因为模型如果不知道自己忘了什么,它就根本不会主动去冷存储里查,必须用静态规则把它钉死在起跑线上。
工具变得越来越聪明,但写代码的底层逻辑从来没变过,把内存交给系统,把规则握在自己手里。